Аудиобейдж помогает превратить живые разговоры в библиотеку примеров. Устройство незаметно пишет звук, сервис с распознаванием речи превращает речь в текст, а разметка выделяет сильные моменты. Команда находит удачные формулировки за минуты, переносит их в карточки обучения и сценарии. Это ускоряет рост новичков и поднимает качество коммуникации на точке.
Что такое аудиобейдж и как он работает
Аудиобейдж — лёгкое устройство на груди, которое пишет разговор продавца с покупателем и синхронизирует запись с сервисом. Микрофон ловит речь, шумодав чистит фон, буфер сохраняет офлайн. После смены запись улетает в облако и обрабатывается распознаванием речи. Получаем расшифровку, таймкоды и быстрый поиск по словам.
Устройство запускает запись по нажатию или по ключевому слову. Световой индикатор показывает активность, чтобы соблюсти прозрачность. Питание держит смену, а док-станция выгружает сессии пакетно. В личном кабинете видны диалоги по времени, сотруднику, магазину. Транскрипция приходит с абзацами и метками пауз, что облегчает разбор.
Связка с распознаванием речи важна, потому что текст ускоряет навигацию. Поиск находит фразу за секунды, клики по словам прыгают к нужному месту аудио. Становится удобно отбирать моменты, сравнивать, собирать подборки. Телефон даёт только длинный файл и рутину перемотки. Здесь всё заточено под обучение и аналитику.
«Речевая аналитика превращает каждый разговор с клиентом в данные: видно, где теряются сделки и что менять в скриптах.»
От обычной записи на телефон отличается стабильным качеством, автосинхронизацией, метками и правами доступа. На телефоне легко потерять файлы и смешать рабочее с личным. Аудиобейдж хранит историю централизованно, и руководитель управляет доступом по ролям. Это снижает барьер для регулярного сбора и ускоряет подготовку материалов.
Зачем собирать библиотеку удачных диалогов
Библиотека превращает единичные удачи в повторяемую практику. В ней видны формулировки, которые сработали, контекст сделки и реакции покупателя. Наставник показывает пример, а новичок повторяет структуру. Команда выравнивает тон общения и технику вопросов. В итоге опыт не теряется, а масштабируется от точки к сети.
Разбор сильных продаж даёт опорные шаги: зацепка интереса, уточнение потребности, проверка бюджета, призыв к действию. В подборках видно, какие слова помогают двигать разговор, а какие тормозят. Такие кейсы быстрее встраиваются в сценарии, чем абстрактные инструкции. Это снижает расхождение между теорией и полем.
Библиотека полезна и для улучшения клиентского опыта: повторяемые практики уменьшают разнобой в сервисе. Покупатель получает ясные ответы и предсказуемый процесс. Руководитель видит, что заходит в речи, и быстро обновляет подсказки. База становится живой системой знаний, где кейсы не пылятся, а работают ежедневно.
Как выстроить процесс сбора и отбора диалогов
Процесс строится просто: фиксировать разговоры в ключевых точках, автоматически чистить шум и распознавать речь, отмечать удачные места, превращать их в учебные карточки. Важно задать правила согласия и хранение. Руководитель утверждает критерии "удачи" и график ревизии. Дальше цикл крутится постоянно и пополняет базу.
Пошаговый процесс сбора и отбора диалогов
- Где и когда фиксировать разговоры — Записывать продажи с высокой долей консультации: сложные товары, дорогие решения, возвраты, установка допуслуг. Фокус на моменты возражений и закрытия сделки. Обозначить запись индикатором и короткой фразой согласия.
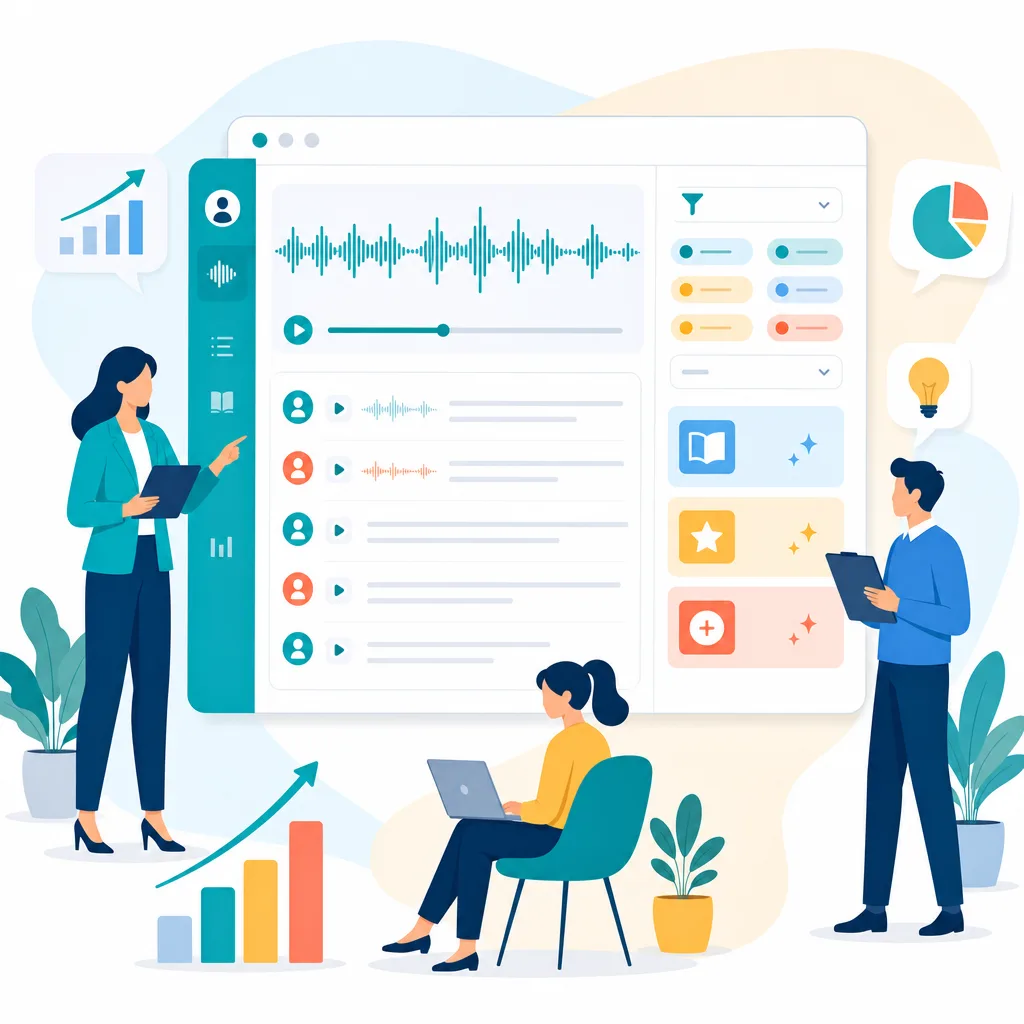
- Автоочистка и сортировка — Шумодав, удаление тишины, нормализация громкости. Автозагрузка в облако, распознаванием речи с таймкодами. Сортировка по магазину, смене, сотруднику, чековым событиям и длительности.
- Отметка удачных фрагментов — Лид отмечает клипами 15–60 секунд, ставит теги: этап, возражение, формулировка, эмоция клиента. Пишет причину успеха в один-два предложения. Добавляет альтернативные фразы для вариативности.
- Преобразование в учебные материалы — Собираются подборки по темам, делаются карточки с задачей, примером, разбором и чек-листом. В шаблон добавляется ссылка на аудио с нужной меткой, чтобы прослушать контекст.
Автоматизация экономит часы рутины. Фильтры по длительности отсекут случайные записи. Теги и оценки проставляют ответственные за участок. Раз в неделю проходит отбор на планёрке, где лучшие фрагменты попадают в библиотеку. Это поддерживает единый стандарт и держит базу актуальной.
Важно зафиксировать политику приватности: информирование клиента, хранение и сроки удаления. Доступ получают только наставники и руководители. Для внешних показов используют обезличенные фрагменты. Это снижает риски и не мешает обучению. Библиотека остаётся инструментом роста, а не архивом сомнительных записей.
Что должна содержать библиотека диалогов
Полезная библиотека отражает реальную воронку. В ней есть типы диалогов, теги, контекст продажи, причины успеха и ошибки. Каждая карточка отвечает на три вопроса: где это сработало, почему это сработало, как повторить. Тогда новичок возьмёт паттерн быстро и без догадок.
Типы диалогов: первичная консультация, квалификация, презентация, работа с возражениями, апселл, кросс-селл, закрытие, постпродажный звонок. Для каждого типа полезно иметь 3–5 живых примеров. Внутри — короткий отрывок, полный контекст и список ключевых реплик. Это даёт структуру и разнообразие.
Теги и категории облегчают поиск: этап, продукт, цена, срок, эмоция клиента, триггеры, конкуренты. Дополнительно — маркеры "тон" и "формулировка". Фильтр по результату сделки покажет рабочие паттерны. Сквозные теги по брендам и сценариям помогут масштабировать практику между точками сети.
Контекст продажи фиксирует канал, время, чек, мероприятия, акцию. Нужны роли участников, повод визита и короткая цель покупателя. Причины, почему диалог признан удачным, пишут конкретно: какая фраза сняла сомнение, какой вопрос открыл потребность, какая пауза помогла. Без этого повторяемость падает.
Отдельный раздел — ошибки и альтернативы. Показываем не только правильный ход, но и промахи: перебили клиента, ушли в характеристики, промахнулись с ценой. Рядом — мягкая альтернатива и объяснение. Такой контраст обучает быстрее, чем идеальная запись без разметки и пояснений.
Аудиобейдж vs диктофон бейдж
Оба устройства пишут звук, но задачи разные. Аудиобейдж заточен под обучение: синхронизация, распознаванием речи, поиск, теги, доступы. Диктофон бейдж — про разовую фиксацию и прослушивание. Для системной библиотеки нужен контроль качества данных и связь с аналитикой. Поэтому базу строят на аудиобейджах.
| Критерий | Аудиобейдж | Диктофон бейдж |
|---|---|---|
| Назначение | Обучение, аналитика, библиотека примеров | Разовая запись для прослушивания |
| Удобство использования | Автовыгрузка, индикатор, роли и доступы | Ручной перенос файлов, минимальные настройки |
| Качество данных | Шумодав, нормализация, таймкоды, метки | Разная громкость, без структурных меток |
| Пригодность для анализа | Поиск по тексту, теги, отчёты, подборки | Только перемотка и прослушивание |
| Роль в обучении продавцов | Готовые клипы, карточки, связь со сценариями | Нужна ручная обработка для учебных целей |
Диктофон бейдж может дополнить процесс на выезде или в редких кейсах. Но без транскрибации, меток и прав доступа он тормозит масштабирование обучения. При росте базы ручная работа множится и качество падает. Для сети магазинов устойчивое решение — аудиобейдж с централизованной обработкой и библиотекой.
Где помогает распознавание речи
Распознавание речи ускоряет путь от записи к знанию. Поиск выдаёт точную цитату, клип формируется по таймкодам, автотеги снимают рутину. Команда быстро находит формулировки для сценариев и подсказок в CRM. Нужные фрагменты выходят на поверхность без перемотки, что экономит часы наставников еженедельно.
С распознаванием речи база фильтруется по ключевым словам: цена, доставка, гарантия, рассрочка, конкурент. Можно искать шаблоны реакции на эмоциональные маркеры. Тематическая разметка группирует отрывки по этапу сделки. Отчёт показывает частоту триггеров и частоту успешных ответов, что помогает обновлять скрипты точечно.
Модель находит удачные реплики автоматически: высокая доля "да", снижение пауз, быстрый переход к следующему шагу. Такие срезы попадают в плейлисты, где наставник уже проводит доработку. Автоматические подсказки снижают шум в базе и удерживают фокус на примерах, которые дают повторяемый результат.
Чувствительные данные маскируются при индексации. Система прячет номера, адреса и имена по словарям и паттернам. Для безопасности включают ротацию токенов доступа и аудит действий. Тогда распознавание речи остаётся инструментом роста, не источником рисков. Обучение идёт спокойно и прозрачно для всех сторон.
Как использовать библиотеку в обучении продавцов
Использование простое: брать короткие клипы по теме и отрабатывать их на планёрках, в микроуроках и наставничестве. Каждый клип идёт с задачей и чек-листом. Новичок слышит пример, повторяет, получает обратную связь. Дальше переносит паттерн на пол. Регулярность важнее разовой интенсива.
Разбор на планёрках. Команда смотрит один клип, фиксирует этап, выписывает слова-триггеры и ошибки. Затем проходит мини-роль-игру по этому же паттерну. Это держит формат компактным и прикладным. Итоги записывают в карточки, чтобы база пополнялась не только аудио, но и выводами.
Микрообучение. По 10–15 минут в день: один клип, один приём, одно упражнение. У сотрудника появляется ритм и ощущение прогресса. Плейлист подбирается под роль и текущую цель. Короткая сессия лучше цепляется к смене и не выпадает из графика. Эффект накапливается за счёт повторения.
Наставничество. Наставник собирает персональную подборку, где примеры совпадают с зоной роста сотрудника. В комментариях даёт альтернативные реплики. Пара проходит спарринг по карточкам и отмечает улучшения. Такой формат ускоряет перенос из примера в речь, потому что обратная связь прилетает сразу после попытки.
Адаптация новых сотрудников. В стартовый набор входят базовые диалоги: приветствие, выявление потребности, работа с популярными возражениями, закрытие. Новичок видит живую реальность, а не сухую схему. За первую неделю он учится узнавать ситуации и выбирать правильный ход, что сокращает время выхода в план.
Тренировка возражений. По каждой частой теме формируется лесенка ответов: мягкий перефрейм, уточняющий вопрос, предложение альтернативы. Блок ведёт к призыву. Примеры из библиотеки доказывают, что фраза не книжная, а рабочая. Это поднимает уверенность сотрудника и снижает долю конфликтных кейсов на точке.
Какие ошибки мешают собрать полезную базу
Частые ошибки — хаотичный сбор, отсутствие тегов, слишком длинные записи без отбора, отрыв от целей обучения и безответная база. Всё лечится процессом и ролью ответственного. Нужен график ревизии, критерии качества и понятные форматы карточек. Библиотека живёт только при регулярном пополнении и чистке.
Хаотичный сбор даёт горы звука без ценности. Лучше ограничить точки записи и заранее проговорить, что ищем: примеры приветствия, обработки цены, мягкого закрытия. Тогда отсев станет проще, а полезных клипов станет больше. Любое расширение списка зон лучше проверять на недельных срезах.
Отсутствие тегов ломает поиск и отбивку тем. Минимальный словарь тегов нужен сразу, иначе каждую неделю придётся переслушивать архив. Начать можно с этапов сделки и частых возражений. Чуть позже добавятся эмоции клиента и маркеры результата. Словарь поддерживает ответственный за контент.
Слишком длинные записи без отбора прячут ценность. Помогают клипы по 15–60 секунд и краткие причины успеха. Нужен принцип: один клип — одна мысль. Тогда карточки не распухают и легко внедряются в микрообучение. Длинные треки оставляют в архиве, а в обучение попадают выжимки.
Когда библиотека не связана с целями обучения, она быстро пустеет. В начале квартала формулируются навыки в фокусе и метрики. Их отражают в плейлистах и отчётах. Отдельно назначается ответственный, который принимает новые клипы, следит за качеством и актуальностью. Без этого база превращается в склад.
Как измерять эффект
Эффект видно по конверсии, скорости адаптации, качеству диалогов, использованию шаблонов и клиентским оценкам. Сравниваются периоды до и после запуска библиотеки. Отчёты строятся по командам и точкам. Цель — удерживать рост на стабильном уровне и вовремя менять подборки. Метрики привязываются к действиям в базе.
Рост конверсии. Смотрим переходы между этапами и финальные продажи. Отмечаем, где библиотека дала прирост: обработка цены, презентация, закрытие. Внутри разбиваем по плейлистам и видим, какие паттерны тянут вверх. Если прироста нет, корректируем теги и обновляем примеры, ближе к текущему спросу.
Сокращение времени обучения. Измеряем от старта до выполнения плана. Если микроуроки с клипами идут ежедневно, отрезок сжимается. Удобно фиксировать часы наставника и число практик на сотрудника. Здесь библиотека экономит ресурс старших, потому что часть демонстраций берут на себя карточки.
Качество диалогов. Оцениваем структуру, ясность и мягкость речи по чек-листу. Плюс долю правильных вопросов и долю неконфликтных завершений. Выборка идёт из свежих записей. Отдельно смотрим появление целевых формулировок в речи — это прямой маркер переноса из библиотеки на пол.
Частота использования шаблонов и клиентские оценки. Смотрим, как часто открывают карточки и сколько клипов уходит в плейлисты. Сверяем с отзывами и NPS. Здесь важен акцент на улучшения клиентского опыта: стабильный тон, меньше длинных пауз, больше ясности в условиях. Эти сигналы должны расти вместе.
Вывод
Аудиобейдж — это не просто запись смены. Он помогает собрать рабочую библиотеку удачных диалогов: поиск по словам, теги, клипы, причины успеха. Дальше — быстрые карточки и плейлисты для практики. Команда растёт быстрее, а покупатель чувствует заботу. Это прямой вклад в улучшения клиентского опыта и выручку.
- Аудиобейдж собирает живые диалоги и упорядочивает их для обучения.
- Связка с распознаванием речи даёт поиск по цитатам, таймкодам и автотегам.
- Библиотека строится на клипах, тегах, контексте и причинах успеха.
- В обучении работают планёрки, микроуроки, наставничество и ролевая практика.
- Эффект виден по конверсии, скорости адаптации и клиентским оценкам.
Хотите так же?
Оставьте контакты — покажем тренажёр на ваших сценариях и метриках онбординга.