Чек-лист тайного покупателя можно превратить в критерии ИИ для оценки разговоров с аудиобейджей. Каждый пункт нужно описать через наблюдаемое действие, баллы и условия неприменимости. Перед запуском оценки модели сверяют с независимой проверкой человека на записях разных ситуаций.
Аудиобейдж записывает офлайн-разговор сотрудника с клиентом, а аналитика проверяет его по согласованным правилам. Такой подход не заменяет весь визит тайного покупателя. Например, запись не покажет чистоту витрины или наличие ценника, если участники об этом не говорят.
По запросу «чек лист тайного покупателя» легко найти десятки образцов анкет. Но готовые пункты редко подходят для автооценки без переработки. В них могут смешиваться слова сотрудника, впечатление клиента и наблюдения о торговом зале. Для каждого типа проверки нужен свой источник.
Что такое критерии ИИ-оценки в чек-листе тайного покупателя
Критерий ИИ-оценки — это правило, по которому модель ищет конкретное действие в записи и назначает результат. Исходный стандарт описывает ожидание компании, критерий переводит его в проверяемые признаки, а итоговый балл показывает результат по согласованной шкале.
Требование «вежливо общается» оставляет слишком много места для трактовки. Один проверяющий сочтёт достаточным спокойный тон, другой будет ждать приветствия и обращения по имени. Для записи лучше выделить отдельные действия: поздоровался, не перебивал и не использовал грубые слова.
Критерии оценки удобно привязать к этапам продажи: приветствию, выявлению потребности, презентации, работе с возражениями и завершению. При этом разговор не обязан идти строго по схеме. Клиент может сразу назвать товар, отказаться от консультации или прервать общение.
Например, анкета тайного покупателя содержит пункт «выяснил потребность». Для ИИ его можно разбить на вопрос о задаче клиента и уточнение важных ограничений. По каждому действию заранее задают признак выполнения и фрагмент разговора, который служит подтверждением.
«Речевая аналитика превращает каждый разговор с клиентом в данные: видно, где теряются сделки и что менять в скриптах.»
Модель оценивает содержание доступной записи, а не намерение сотрудника. Слова «сейчас уточню» могут подтвердить обещание проверить информацию, но не доказывают, что человек действительно это сделал. Оценку также ограничивают границами разговора и качеством записи.
Как подготовить чек-лист к переносу в автооценку
Подготовка начинается с разбора анкеты: команда отмечает повторы, условия сценариев и пункты, которые нельзя проверить по звуку. Затем она сохраняет только те речевые действия, для которых может определить доказательство, баллы и случаи неприменимости.
Сначала полезно собрать все версии стандарта: анкету тайного покупателя, памятку продавца и правила ручной проверки. Одинаковые пункты объединяют, а противоречия передают владельцу стандарта. Иначе модель получит разные требования к одному и тому же действию.
Затем пункты распределяют по этапам продажи и типу поведения. Например, вопрос о бюджете относится к выявлению потребности, а предложение следующего шага — к завершению. Отдельно стоит отметить общие правила общения, которые действуют на протяжении всего разговора.
Обязательное действие должно появиться в каждом подходящем сценарии. Желательное действие улучшает консультацию, но его пропуск можно оценить мягче. Критическое нарушение, например грубое оскорбление клиента, требует отдельного правила и проверки спорных случаев человеком.
Фразы «создал доверие», «хорошо проконсультировал» и «проявил заинтересованность» нельзя надёжно проверить как единое действие. Вместо них команда выбирает признаки: задал уточняющий вопрос, объяснил свойство товара и связал его с названной задачей клиента.
До настройки ИИ нужно согласовать словарь эквивалентов, шкалу, вес пунктов и обработку неопределённости. Например, вопрос о бюджете может звучать без слова «бюджет». Команда также решает, какие цитаты подтверждают оценку и кто разбирает спорные случаи.
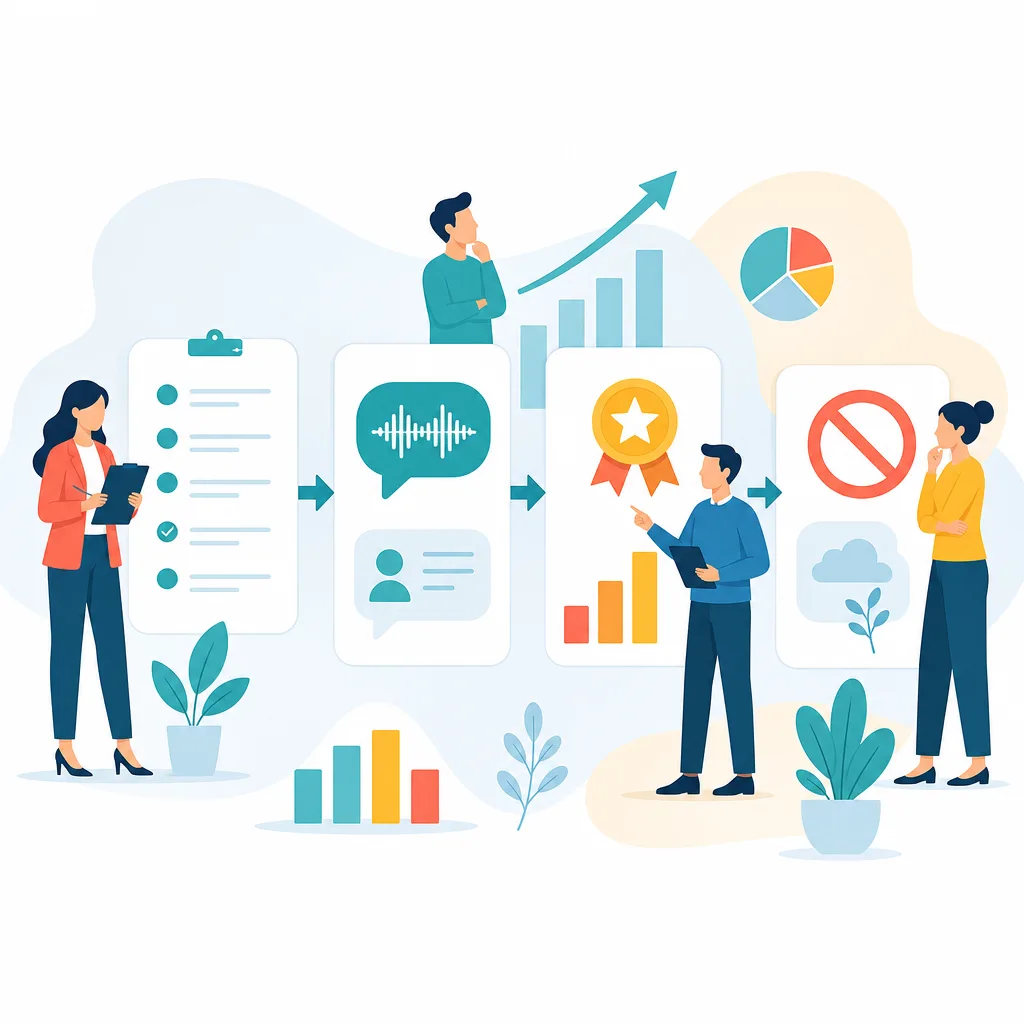
Пункт исключают из речевой оценки, если аудио в принципе не может подтвердить действие. Проверку выкладки товара лучше оставить для осмотра. Неприменимый пункт сохраняют в модели, но не оценивают в конкретном разговоре, когда заранее заданное условие не наступило.
Исходный пункт «предложил подходящий товар» требует разбора. Сначала команда определяет, какие слова подтверждают предложение, а затем решает, как связать товар с озвученной потребностью. Если клиент не сообщил задачу, модель не должна придумывать основание для такой связи.
Как сформулировать критерий, баллы и неприменимый пункт
Рабочий критерий называет действие, участок разговора, признак выполнения и правило баллов. Он также описывает, что не засчитывать, когда пункт неприменим и как поступить при неразборчивой записи. По такому правилу человек и ИИ могут проверять один и тот же факт.
Например, формулировка пункта о потребности может звучать так: «До рекомендации сотрудник уточнил, для какой задачи клиент ищет товар». Засчитывают вопрос или пересказ уже названной задачи с подтверждением клиента. Общую фразу «могу помочь» за уточнение не принимают.
Если анкета требует «поздоровался, представился и предложил помощь», лучше разделить её на три критерия. Тогда пропуск имени не скроется за выполненным приветствием. Такой разбор также покажет руководителю, какой навык требует внимания, а не только снизит общий результат.
Для одного действия подходит шкала от нуля до одного: один балл за подтверждённое выполнение, ноль за подтверждённый пропуск. Для более сложного действия команда может согласовать два балла: один за вопрос о задаче, второй за уточнение важного ограничения клиента.
Сравнение ниже показывает, как исходные формулировки превращаются в проверяемые правила. Условия в таблице служат примерами: компания должна согласовать их со своим стандартом и проверить на реальных записях, прежде чем использовать баллы в регулярной отчётности.
| Формулировка | Что проверяет ИИ | Правило начисления баллов | Когда пункт неприменим |
|---|---|---|---|
| Поприветствовал клиента | Слова приветствия в начале доступного разговора | 1 — приветствие есть; 0 — пропущено | Начало разговора отсутствует в записи |
| Выяснил задачу | Вопрос о задаче или подтверждение уже названной задачи | 1 — задача уточнена; 0 — уточнения нет | Клиент ушёл до начала консультации |
| Отработал возражение | Ответ сотрудника на выраженное сомнение клиента | 1 — ответил по существу; 0 — проигнорировал | Клиент не выразил сомнений |
| Предложил следующий шаг | Предложение оформить покупку или договориться о продолжении | 1 — предложение есть; 0 — отсутствует | Клиент прервал разговор до завершения |
Отрицательный критерий проверяет не полезное действие, а нарушение. Например, за подтверждённое оскорбление можно назначить отдельный штраф или передать запись на ручную проверку. Правило должно уточнять, что считается оскорблением и как поступать с цитатой клиента.
Неприменимый пункт не входит в знаменатель итоговой оценки. Если доступны три пункта из четырёх и по ним набрано два балла, результат составит два из трёх, а не два из четырёх. Пропуск действия при выполненных условиях, напротив, получает ноль по соответствующему критерию.
Условия неприменимости задают заранее, а не выбирают после просмотра результата. Если клиент не выразил сомнений, проверять ответ на возражение не нужно. Если клиент завершил разговор до этапа предложения, пункт о следующем шаге может стать неприменимым по правилу компании.
Неприменимость отличается от неопределённости. Когда запись плохо слышна, нельзя уверенно утверждать, что приветствия не было. Такой случай лучше пометить как «не удалось определить» и отправить на проверку. Если клиент не назвал бюджет, нельзя считать, что сотрудник его уточнил.
Промт для ИИ может включать такую инструкцию: «Проверь вопрос о задаче до рекомендации. Дай один балл за вопрос или подтверждённый пересказ, ноль за пропуск. Если начало не слышно, укажи неопределённость и приведи доступную цитату». Промт не должен требовать положительной оценки.
Чем автооценка отличается от проверки человеком
Тайный покупатель оценивает собственный визит и может заметить обстановку, а ИИ проверяет содержание записанных разговоров. При одинаковых речевых пунктах результаты можно сравнивать. Но модель не видит то, чего нет в аудио, и не получает личного впечатления посетителя.
Аудиобейджи и речевая аналитика позволяют применять одни правила к большому потоку офлайн-разговоров. Руководитель получает возможность искать пропущенные действия и спорные эпизоды. Фактический охват зависит от числа записей, их качества и настроек процесса.
Ошибки распознавания речи важны для любого критерия: неверная расшифровка может скрыть вопрос или приписать слова другому участнику. Результат лабораторного теста ниже относится к телефонной речи, а не к работе аудиобейджей в торговом зале.
Плохая слышимость, перебивания и несколько говорящих усложняют оценку. На записи сотрудник может отвечать одному клиенту, пока рядом звучит другой разговор. Поэтому проверяющему нужны доступ к исходному аудио и возможность отличить недостаток записи от пропуска по стандарту.
Расхождение с человеком возникает и при хорошем звуке. Эксперт может засчитать косвенный вопрос, а модель — искать только прямой. Другая причина — разные правила баллов: один проверяющий считает пересказ потребности выполнением, другой ждёт отдельного вопроса.
Автоматическая оценка не гарантирует правильный результат только потому, что критерий записан подробно. Модель может ошибиться в контексте, а человек — пропустить реплику. Для важных нарушений, пограничных случаев и записей с низкой разборчивостью нужна ручная проверка.
Полезно хранить вместе с оценкой цитату, участок записи и версию правила. Тогда руководитель сможет проверить основание вывода, а не спорить с одним числом. Если цитата не подтверждает результат, случай возвращают на разбор критерия и работы модели.
Как провести калибровку оценки на записях
Калибровка оценки начинается с независимой проверки одной выборки человеком и ИИ. Затем команда сравнивает результаты по каждому критерию, разбирает причины расхождений и уточняет правила. После изменений проверку повторяют на записях, которые не использовали для настройки.
Для пилота отбирают разговоры из разных точек и сценариев: короткие обращения, полноценные консультации, отказы и диалоги с возражениями. В выборку включают разные этапы продажи и записи с проблемным звуком. Эксперту не показывают ответ модели до завершения его оценки.
Общий балл может совпасть случайно, даже если человек и модель по-разному оценили отдельные действия. Поэтому для каждого пункта сравнивают выполнение, пропуск, неприменимость и неопределённость. Расхождения записывают вместе с цитатой, причиной и решением эксперта.
Для оценки согласия можно использовать коэффициент каппа Коэна: он учитывает совпадения, которые могли возникнуть случайно. Его предельное значение ниже описывает свойство метрики, а не результат пилота OrbitAI. Подтверждённый показатель конкретного пилота нужно запросить у его владельца.
Каппа не заменяет просмотр спорных записей. Совпадение итоговых классов не объясняет, правильно ли оценщики поняли стандарт. Размер выборки и порог приемлемого расхождения команда согласует с владельцами процесса; единой нормы для всех критериев и сценариев нет.
Причины ошибок удобно разделить на группы: неоднозначная формулировка, неверные баллы, неприменимость, качество звука и ошибка модели. Сначала уточняют смысл критерия и примеры, затем меняют шкалу или условия. Исправлять промт, не разобрав источник ошибки, недостаточно.
Спорные примеры рассматривают вместе с экспертами, которые отвечают за стандарт. Они решают, какие реплики считать эквивалентными и как оценивать частичное выполнение. Итог фиксируют в правилах и добавляют подтверждающий фрагмент записи в набор примеров для проверки.
После любого изменения критериев выборку оценивают повторно, включая отдельные записи для проверки без предварительной настройки. Для дальнейшей калибровки сохраняют пограничные случаи, типовые диалоги и новые сценарии. Доступ к записям ограничивают по правилам компании.
Как запускать оценку разговоров на аудиобейджах
Запуск идёт по последовательности: проверить чек-лист, настроить критерии, провести пилот, сверить оценки с человеком и начать регулярную проверку. На каждом шаге владелец стандарта утверждает правила и отвечает за разбор ошибок, а не только за итоговый показатель.
До пилота команда проверяет, что запись относится к нужному сотруднику и сценарию. Также она определяет границы разговора и правила работы с персональной информацией. Сотрудников и клиентов информируют о записи в соответствии с применимыми требованиями и правилами компании.
Аудиобейджи OrbitAI помогают собирать записи офлайн-разговоров, а речевая аналитика применяет к ним согласованные критерии. Перед оценкой важно проверить слышимость и корректность привязки записи. Ошибка на этом этапе может исказить результат даже при понятном стандарте.
Результаты используют не только для общего балла. По отдельным критериям руководитель находит частые пропуски, выбирает разговоры для обратной связи и отправляет неопределённые случаи человеку. Сравнивать сотрудников стоит лишь при сопоставимых сценариях и достаточном числе записей.
После запуска команда регулярно проверяет качество аудио и причины расхождений. Новые товары, сценарии и возражения могут потребовать изменений стандарта. Каждую новую версию правил сначала проверяют на записях, а затем отмечают дату её действия в системе учёта оценок.
- Критерий ИИ описывает наблюдаемое речевое действие, место его поиска и доказательство. Общие впечатления вроде «создал доверие» нужно заменить конкретными признаками.
- Баллы назначают по заранее согласованной шкале. Несколько самостоятельных действий лучше оценивать отдельно, а критические нарушения выносить в собственное правило.
- Неприменимый пункт исключают из знаменателя, когда наступило оговорённое условие. Пропуск получает ноль, а неразборчивую запись отмечают как неопределённую.
- При калибровке человек и ИИ независимо оценивают одни записи. Команда разбирает расхождения по каждому пункту, уточняет правила и повторяет проверку на отдельной выборке.
Хотите так же?
Оставьте контакты — перезвоним и покажем Orbit.AI на ваших задачах.