Пилот позволяет проверить ИИ-агента на ограниченной части заявок, прежде чем передавать ему весь поток. Команда выбирает понятный сценарий, записывает исходные показатели и сравнивает результаты с работой сотрудников. Через две недели руководитель получает основание для решения, а не обещание заранее известного результата.
Для проверки подойдёт, например, первичный ответ на заявки с сайта. Агент уточняет запрос и передаёт сложные случаи человеку. До публикации частотность запросов «ИИ-агент для бизнеса» и «ИИ-агент для обработки заявок» нужно проверить по актуальной выгрузке: без неё нельзя подтвердить, что оба запроса высокочастотные.
Что такое пилот ИИ-агента
Пилот ИИ-агента — это ограниченная проверка на реальных заявках с заранее заданными правилами и метриками. Команда выбирает часть обращений, разрешённые действия и срок наблюдения. Остальные заявки продолжают идти по привычному маршруту, поэтому ошибка в одном сценарии не затрагивает весь поток.
В отличие от полного внедрения пилот не требует сразу менять работу всех сотрудников и каналов. ИИ-агент для обработки заявок может отвечать только на входящие обращения с одной формы. Если возникнет сбой, ответственный вернёт этот участок сотрудникам и проверит причину до следующего запуска.
Хорошая проверка отвечает на несколько конкретных вопросов. Доходит ли заявка до следующего этапа, насколько быстро клиент получает ответ и сколько времени тратит команда на исправления. Отдельно оценивают качество диалога: быстрый ответ не поможет, если агент неверно понял запрос или пообещал лишнее.
«Речевая аналитика превращает каждый разговор с клиентом в данные: видно, где теряются сделки и что менять в скриптах.»
Демонстрация показывает возможности продукта на подготовленных примерах, а функциональный тест проверяет отдельное действие. Пилот отличается работой с настоящими обращениями и сравнением результата. Например, успешная отправка сообщения ещё не доказывает, что клиент получил точный ответ и заявка сохранилась в системе.
Как выбрать поток заявок и контрольную группу
Для пилота лучше выбрать стабильный поток с понятным сценарием и доступной историей обращений. Подойдёт типовой запрос на консультацию, если команда видит источник заявки, время поступления и следующий этап. Редкие сложные обращения оставляют сотрудникам: по ним труднее быстро собрать сравнимые наблюдения.
Тестовая группа получает обработку с участием агента, контрольная группа проходит привычный маршрут. Заявки распределяют случайно по заранее заданному правилу, не выбирая удобных клиентов вручную. Такое сравнение называют A/B: группы работают одновременно, а различие между ними состоит прежде всего в способе обработки.
Например, система случайно направляет по 10% подходящих заявок в каждую из двух групп. Остальные 80% идут как обычно и не входят в основное сравнение. Это пример распределения, а не требование к размеру потока. Каждой заявке присваивают группу до первого контакта и сохраняют запись о назначении.
Группы должны быть сопоставимы по источнику, типу обращения и времени поступления. Если агент получает ночные заявки, а сотрудники только дневные, результат может зависеть от графика клиентов. После распределения команда проверяет состав групп и отдельно показывает перекосы, а не исправляет их выборочным удалением заявок.
Как подготовить пилот
Подготовка начинается с одного сценария, понятных полномочий и маршрута к человеку. Для стартового теста агент может уточнить потребность, записать контакт и предложить время консультации. Цены с индивидуальными условиями, претензии и вопросы вне базы знаний лучше сразу направлять сотруднику.
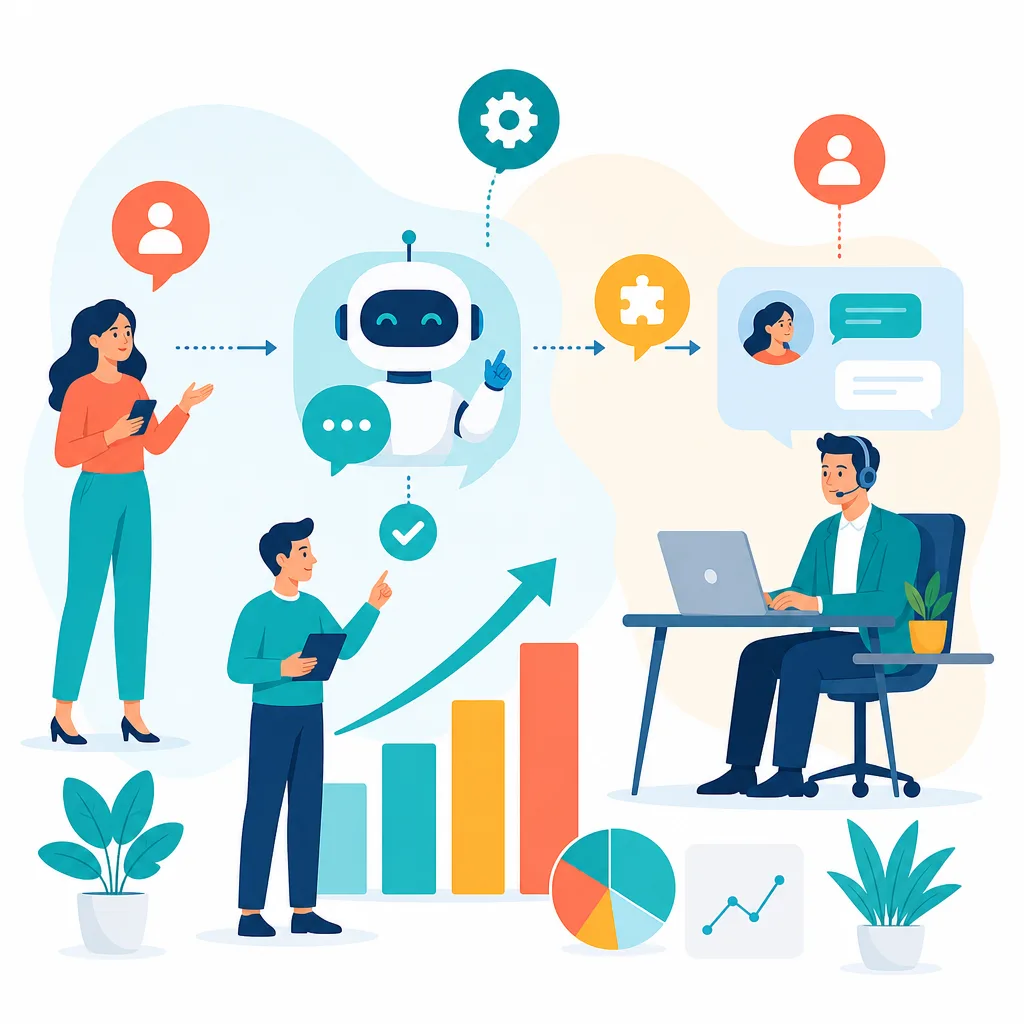
Команда заранее решает, как использовать ИИ агента при недостающей информации и отказе клиента продолжать разговор. Для передачи человеку нужны причина, история диалога и ответственный сотрудник. Если сотрудник недоступен, система должна сохранить заявку и показать её в очереди, а не завершить обращение без следа.
До старта руководитель записывает исходные показатели и согласует владельца пилота, график проверок и порядок разбора ошибок. Отдельно фиксируют критерии остановки: например, потерю заявки или систематическую передачу неверных контактов. Порог должен быть понятен команде до первого обращения, а не появиться после сбоя.
Не стоит одновременно менять скрипт сотрудников, канал входа и правила маршрутизации. Иначе команда не поймёт, что повлияло на результат. Полезно также проверить записи событий на нескольких пробных обращениях: время первого ответа, назначение группы, передачу человеку и переход заявки на следующий этап.
Какие метрики измерять
Метрики пилота делят на результат, качество и нагрузку. К первой группе относят обработанные заявки и переход на следующий этап, ко второй — ошибки и корректность ответа. Нагрузку показывают время до первого ответа, доля передач сотруднику и затраты на обработку. Для каждой метрики заранее задают формулу и источник.
Долю обработанных заявок считают от всех заявок, назначенных в группу, включая потерянные и ошибочные. Конверсию в следующий этап считают от той же исходной базы, если так записано в плане. Время первого ответа сравнивают по медиане и по доле обращений, получивших ответ в согласованный срок.
Одной конверсии недостаточно: она может вырасти, пока команда исправляет ошибки агента вручную. Поэтому вместе с переходами считают долю передач, неверные ответы и время сотрудников. Стоимость обработки включает работу людей и расходы на решение за период; одинаковые статьи затрат применяют к обеим группам.
Значения групп сравнивают за одинаковый период и по одинаковым определениям. Разницу показывают в процентных пунктах, а рядом указывают число заявок и неопределённость оценки. За две недели небольшой поток может дать лишь предварительный сигнал. Для надёжного сравнения заранее оценивают нужную выборку и мощность теста.
Как провести пилот за две недели
Двухнедельный пилот удобно вести по этапам: подготовить правила, проверить запуск, наблюдать поток и затем свести результаты. Срок подходит для одного ограниченного сценария, но не гарантирует достаточного числа наблюдений. Если заявок мало, команда может продлить проверку или ограничиться выводами о работоспособности.
До запуска команда фиксирует сценарий, состав групп, формулы метрик и правила передачи человеку. В плане записывают главную метрику и условия остановки. Проверка на нескольких пробных обращениях помогает убедиться, что агент не отвечает вне полномочий, а сотрудник получает историю и контакт клиента.
В начале пилота ответственный сверяет маршрутизацию с журналом событий. Для каждой заявки должны сохраниться группа, время поступления, первый ответ и дальнейший маршрут. Если записи расходятся с CRM, сначала устраняют причину. Без корректного учёта даже внешне гладкий разговор не даст надёжного результата.
Во время запуска команда ежедневно проверяет сбои и обращения, переданные сотрудникам. Ошибки исправляют, но критерии оценки не меняют задним числом ради лучшего отчёта. Существенное изменение сценария записывают с датой и отдельно оценивают его влияние: результаты до и после изменения могут быть несопоставимы.
В середине периода руководитель разбирает разговоры разных типов и проверяет классификацию исходов. Например, система могла пометить заявку успешной после отправки сообщения, хотя клиент не получил ответа на вопрос. Если ошибка встречается часто, команда проверяет правила разметки и исправляет учёт с сохранением истории.
В конце второй недели результаты сводят по группам и важным сегментам, затем отделяют сигналы от устойчивых выводов. Команда может увидеть повторяющуюся ошибку в диалогах уже на малой выборке. Но небольшая разница конверсии при малом числе заявок ещё не доказывает преимущество одного способа обработки.
Какой способ сравнения выбрать: A/B или сравнение до и после
A/B с контрольной группой обычно лучше отделяет влияние агента от внешних изменений, если поток и распределение позволяют такое сравнение. Но это не единственный способ проверки. Команда может сравнить периоды до и после запуска или сначала проверить сам сценарий на ограниченном потоке без контрольной группы.
| Способ | Как устроен | На какой вопрос отвечает | Ограничение |
|---|---|---|---|
| A/B с контрольной группой | Одновременно сравнивают сопоставимые группы заявок | Чем отличаются результаты обработки с агентом и без него | Нужны достаточный поток и корректное распределение |
| Сравнение до и после | Результаты запуска сравнивают с предыдущим периодом | Изменились ли показатели после включения агента | На результат могут повлиять сезонность и другие изменения |
| Ограниченный тест без контроля | Агент обрабатывает часть заявок, результаты разбирает команда | Работает ли сценарий и где возникают ошибки | Не доказывает причинный эффект |
При A/B обе группы работают одновременно, поэтому сезонные колебания обычно затрагивают их вместе. Случайное распределение снижает риск отбора удобных обращений, но не исправляет ошибки учёта. Если сотрудники по-разному обрабатывают переданные заявки, этот факт тоже нужно описать при разборе результата.
Сравнение до и после подходит, когда параллельную контрольную группу выделить нельзя. При этом спрос, состав команды и процессы могли измениться между периодами. Полезно сопоставить одинаковые дни недели и источники обращений, а заметные изменения записать в отчёт. Это уменьшит путаницу, но не докажет причину разницы.
Тест без контроля помогает понять, как пользоваться ИИ агентами на реальных обращениях и где ломается маршрут. Его результат полезен для исправления ошибок и решения о следующем этапе. Но рост показателя относительно ожиданий сам по себе не показывает, насколько именно агент изменил бизнес-результат.
Как собрать выборку разговоров
Выборка разговоров должна охватывать разные дни, источники и типы заявок, а не только удачные примеры. Команда заранее задаёт правило отбора и случайно выбирает обращения внутри каждой важной категории. Для сопоставления полезно проверять разговоры обеих групп по одинаковым критериям качества.
При отборе отдельно учитывают успешные, неуспешные и переданные сотруднику обращения. Редкие ошибки можно дополнительно взять в разбор, но их долю нельзя считать по такой подборке как по случайной выборке. В отчёте указывают число проверенных разговоров и правило, по которому каждый из них попал в анализ.
Для ручной проверки назначают ответственного и простую разметку: понял ли собеседник запрос, дал ли точный ответ и сохранил ли следующий шаг. Проверяющий отмечает также лишние обещания и ошибки передачи. Спорные случаи разбирает второй сотрудник; решение и причину фиксируют в общей таблице.
Разбор разговоров помогает объяснить показатели, но не заменяет сравнение групп по всем заявкам. Например, несколько неудачных диалогов могут выявить неверный ответ о цене, но не показывают частоту ошибки во всём потоке. Для оценки частоты нужна подходящая выборка с понятными правилами отбора.
Какие риски ограничить во время пилота
Главный риск — потерять заявку или дать клиенту неверный ответ. Его ограничивают узкий сценарий, проверенные материалы и понятная передача сотруднику. Журнал событий должен показывать каждое поступление и итог обработки. Если агент не уверен в ответе или клиент просит человека, обращение уходит в очередь сотрудников.
Сравнение искажают ручной отбор заявок, неполные записи и разные правила учёта. Защита состоит в случайном распределении, контрольной проверке групп и регулярной сверке журнала с CRM. Нагрузку сотрудников тоже отслеживают: частые передачи могут незаметно увеличить очередь даже при быстром первом ответе.
Пилот стоит приостановить, если журнал показывает поступление заявки, а сотрудник и CRM её не видят. Сначала команда возвращает обработку людям, ищет пропавшие обращения и проверяет настройку маршрута. Продолжать запуск ради соблюдения срока опаснее, чем перенести итоговую оценку и заново проверить исправление.
Как оформить итоговый отчёт и принять решение
Итоговый отчёт связывает сценарий, период и объём групп с результатами проверки. В нём показывают исходные условия, формулы метрик, показатели обеих групп и разбор выборки разговоров. Отдельно записывают изменения по ходу запуска, неполные записи и ограничения, которые мешают уверенно объяснить разницу.
Решение может быть одним из трёх: расширить пилот, доработать сценарий и повторить проверку или остановить запуск. Расширение оправданно, когда выполнены заранее заданные условия качества и безопасности, а результат достаточно убедителен для масштаба решения. При повторяющихся ошибках сначала исправляют причину.
Отчёт должен прямо показывать, каких сведений пока не хватает. Если поток мал, команда может знать, как начать пользоваться ИИ агентом без потери заявок, но не знать его влияние на конверсию. Тогда следующий шаг — продлить сравнение или собрать больше обращений, а не объявлять предварительный сигнал доказанным эффектом.
- Выберите ограниченный поток с понятным сценарием и доступной историей заявок.
- Распределяйте обращения случайно и проверяйте сопоставимость групп.
- Заранее задайте метрики, правила эскалации и условия остановки.
- Разберите выборку разговоров, включая ошибки и передачи сотрудникам.
- По итоговому отчёту решите, расширять пилот, дорабатывать его или остановить.
Хотите так же?
Оставьте контакты — покажем, как ИИ-агент закрывает рутину ваших менеджеров.