Точность нейросети проверяют на одной пилотной выборке: модель и независимые эксперты оценивают одинаковые материалы по общей шкале. Совпадения итоговых баллов недостаточно. Нужно проверить согласованность оценок, найти систематические расхождения и понять, меняют ли они кадровое решение.
Надёжный пилот начинается с понятных критериев и разнообразных примеров работы сотрудников. Затем команда сравнивает баллы, изучает спорные случаи и проверяет ограничения модели. Такой порядок помогает решить, можно ли расширить применение системы или сначала нужно изменить шкалу и повторить проверку.
Что такое проверка точности ИИ-оценки персонала
Проверка точности — это сопоставление оценок модели и независимых экспертов на одних материалах и по одной шкале. Например, руководители и нейросеть отдельно разбирают записи учебных переговоров. После этого команда сравнивает баллы по каждому навыку, а не только общий результат сотрудника.
Экспертный балл не равен объективной истине. Руководитель может не заметить важную реплику или иначе понять описание уровня. Поэтому результаты оценки персонала стоит сопоставлять с несколькими независимыми мнениями. Если эксперты сами часто расходятся, сначала потребуется уточнить правила оценки.
Точность в пилоте описывает близость к принятому экспертному ориентиру. Согласованность показывает, насколько оценки повторяют друг друга. Валидность отвечает на другой вопрос: действительно ли шкала измеряет нужный навык и подходит для конкретного решения. Даже одинаковые баллы не доказывают валидность.
«Речевая аналитика превращает каждый разговор с клиентом в данные: видно, где теряются сделки и что менять в скриптах.»
Высокая корреляция означает похожий порядок сотрудников, но не одинаковые оценки. Модель может каждому поставить на балл больше эксперта и сохранить тот же рейтинг. По итогам пилота компания решает, расширять проверку, уточнять критерии или пока оставить нейросети только вспомогательную роль.
Что подготовить до пилота
До сравнения нужно зафиксировать критерии, шкалу, состав выборки и правила экспертной разметки. Команда выбирает компетенции под конкретную задачу: например, умение уточнять потребность клиента. Для каждой компетенции стоит определить, какой материал содержит признаки навыка и какое решение зависит от оценки.
Уровни шкалы лучше описывать через действия, которые можно увидеть или услышать. Вместо формулировки «хорошо общается» подойдёт индикатор: «задаёт уточняющий вопрос и проверяет ответ клиента». Для соседних уровней команда приводит разные примеры поведения, чтобы оценщики не додумывали границы.
Пилотная выборка должна отражать будущие условия применения: роли, опыт сотрудников, типы заданий и качество записей. В неё включают типичные и сложные ситуации, а не только удачные примеры. Если в работе встречаются шумные записи или короткие ответы, их долю тоже стоит учесть при отборе.
Экспертные баллы нельзя передавать модели вместе с материалом для оценки. Эксперты также не должны видеть результат ИИ до собственной разметки. Порядок разрешения споров фиксируют заранее: например, после независимых оценок третий специалист проводит разбор и записывает основания итогового решения.
Как спланировать пилотную выборку и экспертную разметку
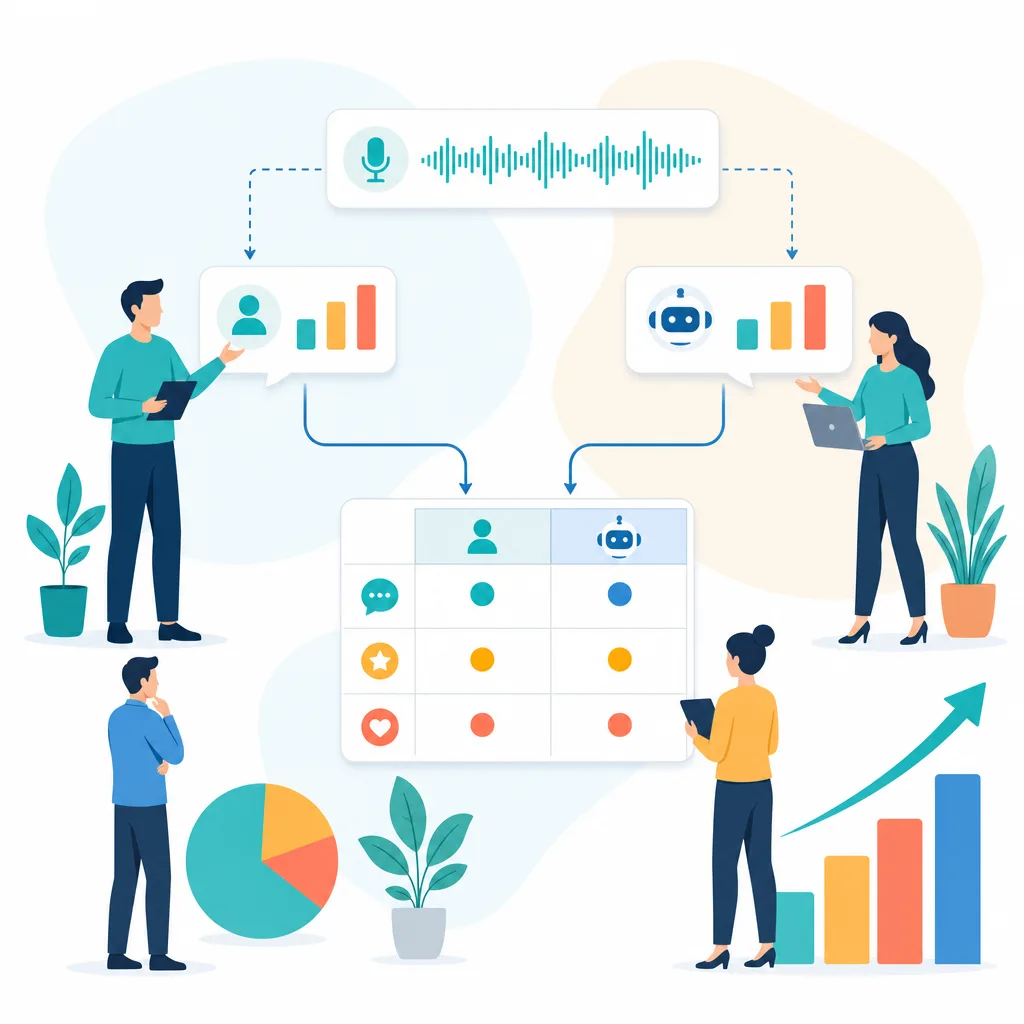
Модель и эксперты оценивают один материал, не зная баллов друг друга. Объём и состав выборки определяют до начала пилота. Единицей анализа может стать запись разговора, ответ на задание или фрагмент интервью. Важно заранее решить, оценивают ли специалисты весь разговор или отдельные эпизоды.
При отборе материалов учитывают роли, опыт, сценарии и условия будущей работы. Если взять только опытных сотрудников и стандартные ситуации, проверка не покажет работу системы на новичках и сложных случаях. Полезно сохранить описание отбора и сравнить состав пилота с реальным потоком оценок.
На часть материалов назначают как минимум двух экспертов. Их независимые оценки позволяют проверить, одинаково ли люди применяют шкалу. Если ресурсов хватает на двойную разметку всей выборки, картина будет подробнее. При ограниченном времени подвыборку формируют так, чтобы в ней были разные уровни и сценарии.
Разметку проводят вслепую: эксперты не видят оценки модели и коллег, а модель не получает экспертных баллов. После завершения независимого этапа команда сопоставляет результаты. Исходные оценки сохраняют даже после обсуждения спора, иначе нельзя будет измерить первоначальную согласованность экспертов.
Универсального размера выборки нет. Он зависит от разнообразия ролей, редкости важных случаев, числа уровней шкалы и точности, с которой команда хочет измерить показатели. До старта фиксируют пропуски и причины исключения записей. Слишком маленькие группы не позволяют надёжно сравнить результаты между ними.
Как сравнить баллы модели и экспертов
Сравнивать нужно совпадение уровней, направление ошибок и согласованность самих экспертов, а не только итоговые баллы. Сначала команда выбирает экспертный ориентир: отдельную оценку, согласованное решение или другой заранее описанный способ. Для каждого варианта сохраняют исходные баллы и правила их объединения.
Доля точных совпадений показывает, как часто модель и эксперт выбрали один уровень. Например, при семи совпадениях на десяти материалах показатель равен 70%. Но оставшиеся три случая могут отличаться на один или на несколько баллов. Поэтому отдельно считают величину и направление каждого расхождения.
Среднее абсолютное расхождение показывает средний размер ошибки без учёта её знака. Медианное расхождение делит случаи пополам и меньше зависит от отдельных крупных промахов. Для уровней 1, 2 и 3 модель с баллами 2, 2 и 3 имеет одно точное совпадение из трёх и среднее абсолютное расхождение 1/3 балла.
Матрица расхождений сводит экспертные уровни в строки, а уровни модели в столбцы. Она показывает, например, как часто экспертный уровень 2 превращается в модельный уровень 3. Отдельно смотрят среднее знаковое расхождение: положительное значение может указывать на завышение, отрицательное — на занижение.
Корреляция описывает сходство ранжирования, а коэффициент согласованности помогает оценить повторяемость баллов. Для категориальных оценок двух экспертов может подойти каппа Коэна; для некоторых числовых шкал применяют ICC. Выбор зависит от шкалы, числа оценщиков и распределения баллов. Один показатель не заменяет остальные.
В той же классификации Landis и Koch называют диапазон 0,81–1,00 почти полной согласованностью. Каппа учитывает ожидаемое случайное совпадение, но её значение зависит и от распределения категорий. Поэтому интерпретацию дополняют долей совпадений, матрицей ошибок и описанием состава выборки.
Экспертная оценка и оценка нейросети: что сравнивать
Сравнение должно показывать, где баллы совпадают, где расходятся и влияет ли расхождение на кадровое решение. Одно дело — разница внутри уровня развития навыка. Другое — ошибка возле границы допуска к самостоятельной работе. Для каждого сценария команда заранее определяет последствия таких случаев.
| Что сравнивают | Что показывает | Ограничение |
|---|---|---|
| Точное совпадение баллов | Долю одинаковых оценок | Не показывает величину остальных расхождений |
| Среднее или медианное расхождение | Размер типичной ошибки | Может скрыть ошибки на отдельных уровнях |
| Корреляция | Сходство направления изменений | Не подтверждает совпадение абсолютных баллов |
| Согласованность экспертов | Насколько единообразно эксперты применяют шкалу | Не подтверждает валидность самой шкалы |
Показатели читают вместе. Высокая доля совпадений может сопровождаться редкими, но критичными ошибками на границе допуска. Небольшое среднее расхождение тоже не гарантирует отсутствие таких случаев. Матрица и отдельный разбор крупных ошибок показывают то, что не видно по общему среднему.
Предположим, эксперты поставили трём сотрудникам баллы 1, 2 и 3. Первая модель дала те же баллы, а вторая — 2, 3 и 4. Обе сохранили порядок и имеют одинаковую идеальную корреляцию с экспертами. Однако первая совпала во всех случаях, а вторая не совпала ни в одном и стабильно завысила оценку.
Результат зависит от типа шкалы и распределения баллов. Когда почти все материалы относятся к одному уровню, даже простая модель может часто совпадать с экспертом. Проверка редких уровней требует отдельных примеров. Согласованность руководителей при этом показывает надёжность разметки, но не доказывает полезность самой шкалы.
Как разбирать расхождения и калибровать шкалу
Расхождение — сигнал для разбора причин, а не автоматическое доказательство ошибки модели или эксперта. Сначала случаи группируют по навыкам, уровням, ролям и типам материалов. Затем проверяют исходные записи и объяснения оценок. Такой разбор помогает отличить случайный промах от повторяющегося сбоя.
Если модель и эксперты расходятся только на среднем уровне навыка, причин может быть несколько. Граница уровня может быть расплывчатой, примеров для калибровки может не хватать, а сценарий — влиять на поведение сотрудника. Ни одну из причин нельзя считать установленной без просмотра материалов и проверки гипотез.
Калибровка шкалы начинается с обсуждения поведенческих индикаторов и спорных примеров. Эксперты отдельно объясняют, какие реплики подтверждают каждый уровень. Если трактовки расходятся, команда уточняет описание и проверяет его на новых материалах. Исходные формулировки и причины изменений сохраняют.
Koo и Li также приводят ориентиры: ICC ниже 0,50 указывает на слабую надёжность, от 0,50 до 0,75 — на умеренную, выше 0,90 — на отличную. Авторы рекомендуют учитывать 95%-й доверительный интервал, а не только точечную оценку. Эти границы не заменяют требования конкретного кадрового процесса.
Калибровка не должна превращаться в подгонку под желаемое совпадение. Изменение шкалы требует объяснения через сам навык, а не только роста метрики. После правок модель и эксперты проходят повторную проверку на отложенной выборке, которую не использовали для настройки. Правила теста фиксируют до его начала.
Как понять, готова ли система к масштабированию
Масштабирование оправдано, когда согласованность приемлема для конкретного процесса, ограничения контролируются, а руководители понимают границы оценки. Порог согласуют до анализа результатов. Для рекомендации учебного упражнения и для допуска к самостоятельной работе последствия ошибки различаются.
При приемлемом совпадении и отсутствии критичных перекосов можно расширить пилот на новые команды. При систематическом завышении или занижении сначала ищут причину и повторяют проверку. Если шкала не измеряет нужный навык, сперва пересматривают критерии, даже когда модель хорошо повторяет экспертные баллы.
Оценку с помощью ИИ не стоит превращать в единственное основание для увольнения, отказа в повышении или другого значимого решения. Человек должен видеть подтверждающие фрагменты, учитывать контекст и иметь право пересмотреть вывод. Сотруднику нужен понятный порядок обсуждения и оспаривания спорной оценки.
Валидность проверяют по связи оценок с тем, ради чего создана шкала. Например, навык выявления потребностей должен отражаться в соответствующих действиях, а не только в длительности ответа. Отдельно изучают ошибки по ролям и доступным группам сотрудников. Малый размер группы требует осторожных выводов.
После запуска команда собирает обратную связь и регулярно проверяет новую выборку с экспертами. Повторный пилот нужен после заметного изменения модели, шкалы, сценариев или состава сотрудников. Рост критичных ошибок, жалобы на перекосы или потеря доступа к материалам для проверки могут стать причиной остановить расширение.
Как выбрать формат проверки и закрепить доверие руководителей
Формат проверки выбирают под тип шкалы, риск решения и доступный объём материалов. Доверие руководителей поддерживают прозрачные критерии и понятный разбор расхождений. По запросам «ии оценка персонала» и «нейросеть оценка персонала» можно найти разные решения, но их обещания всё равно требуют проверки на собственных сценариях.
Двойная независимая разметка всей выборки даёт подробную картину расхождений между людьми. Она полезна, когда спорный балл может повлиять на важное решение. Ограничение подхода — время двух специалистов на каждый материал. Даже полная двойная разметка не гарантирует, что выбранная шкала измеряет нужную компетенцию.
Несколько экспертов на подвыборке снижают нагрузку и позволяют оценить согласованность хотя бы на части пилота. Такой вариант требует внимательного отбора: удобные записи не должны вытеснить сложные и редкие случаи. Результаты подвыборки нельзя без оговорок переносить на роли и сценарии, которых в ней почти нет.
Отложенные материалы нужны, чтобы проверить шкалу или модель после изменений на независимых примерах. Этот подход уменьшает риск подгонки под уже известные случаи, но сам по себе не заменяет экспертную разметку. Если отложенная выборка не похожа на будущий поток, её результат тоже будет сложно обобщить.
Руководителям стоит показать распределение совпадений и ошибок, а не один итоговый процент. Полезно разобрать несколько типичных случаев с записью, баллами и пояснениями экспертов. Рядом указывают состав выборки, ограничения и порядок пересмотра. Экспертная оценка тоже требует проверки согласованности.
Перед решением о расширении команда сверяет единую шкалу, независимость разметки и состав пилота. Затем проверяет несколько метрик, причины ошибок и валидность критериев. Последние пункты — участие человека в значимых решениях и повторный контроль после запуска. Если хотя бы один пункт не закрыт, его включают в план доработки.
- Модель и независимые эксперты оценивают одинаковые материалы по заранее согласованной шкале.
- Точное совпадение, величина ошибок и корреляция отвечают на разные вопросы.
- Разметку экспертов тоже проверяют на согласованность, а шкалу — на валидность.
- Систематические расхождения разбирают до расширения пилота.
- После изменений качество проверяют на отложенных материалах.
- Значимые кадровые решения остаются под контролем человека.
Хотите так же?
Оставьте контакты — перезвоним и покажем Orbit.AI на ваших задачах.