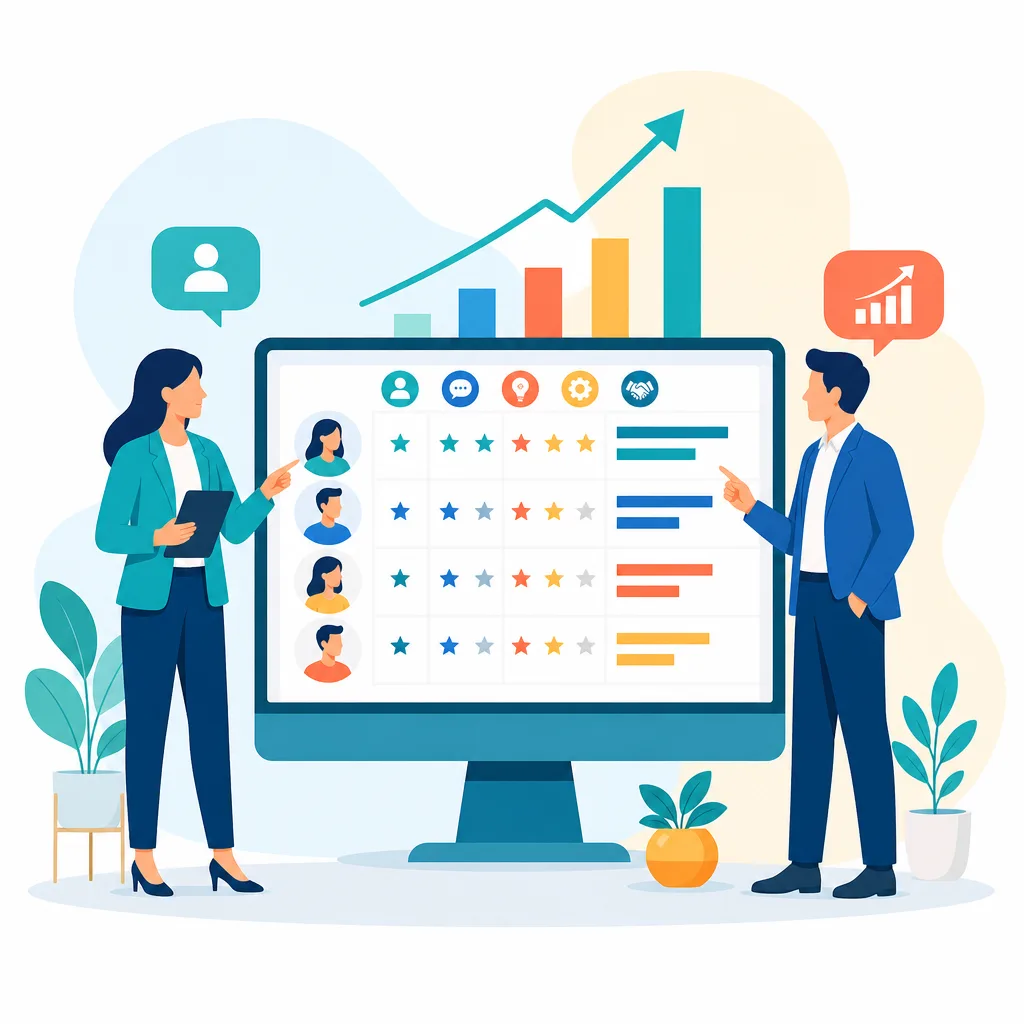
Оценка кандидатов с помощью ИИ помогает сопоставлять интервью по общим критериям и одной шкале. Система разбирает ответы, отмечает признаки компетенций и формирует рекомендацию. Интервьюер проверяет выводы по материалам беседы и принимает решение с учётом требований вакансии.
Общий стандарт особенно полезен, когда одну вакансию ведут несколько рекрутеров и руководителей. Без него оценка «сильный кандидат» может означать совсем разные вещи. Шкала и примеры ответов помогают понять, за что именно человек получил балл, а где интервьюеру пока не хватило фактов.
Что такое оценка кандидатов с помощью ИИ
Оценка кандидатов с помощью ИИ — это разбор ответов по заранее заданным признакам компетенций. Система сопоставляет материалы интервью с критериями и предлагает оценку. Её задача не угадать характер человека, а показать, какие ответы подтверждают нужные для работы навыки и каких свидетельств не хватает.
Для анализа можно использовать расшифровку разговора, ответы на одинаковые вопросы и заметки интервьюера. Набор материалов зависит от инструмента и настроек процесса. Важно заранее определить, какие сведения действительно нужны для вакансии, кто получит к ним доступ и сколько времени они будут храниться.
Оценка компетенции отвечает на вопрос, проявил ли кандидат конкретный навык и в чём это видно. Скоринг переводит результат в балл по выбранной шкале. Рекомендация связывает оценки с правилами отбора: например, предлагает продолжить интервью или собрать дополнительные свидетельства по слабому критерию.
«Речевая аналитика превращает каждый разговор с клиентом в данные: видно, где теряются сделки и что менять в скриптах.»
Эти три результата не стоит смешивать. Высокий общий балл может скрыть пробел в обязательном навыке, а осторожная рекомендация не означает автоматический отказ. Специалист смотрит на отдельные компетенции, проверяет цитаты и учитывает обстоятельства, которые система могла пропустить при разборе.
Почему интервьюеры оценивают одного кандидата по-разному
Интервьюеры расходятся в оценках, когда задают разные вопросы и ждут разных доказательств навыка. Один просит рассказать о сложной сделке, другой обсуждает мотивацию. Даже при равной продолжительности бесед они получают разные материалы, поэтому итоговые баллы нельзя уверенно сравнить напрямую.
На результат влияют и ожидания от роли. Для одного руководителя самостоятельность означает способность самому найти решение. Для другого важнее вовремя согласовать риск с командой. Если эти признаки не обсудить до встречи, одинаковый ответ получит разные оценки без очевидной ошибки со стороны интервьюеров.
Личное впечатление тоже меняет восприятие ответа. Уверенная речь может создать ощущение опыта, хотя конкретного примера в рассказе нет. Сдержанный кандидат, напротив, иногда подробно описывает полезные действия, но производит менее яркое впечатление. Шкала помогает отделить стиль общения от проверяемого навыка.
Без записанных оснований сложно разобрать расхождение после интервью. Формулировки «понравился» и «не убедил» не показывают, какие действия кандидата оценили. Общие вопросы, описание уровней и ссылки на ответы превращают обсуждение в проверку фактов, хотя полностью убрать различия в суждениях не могут.
Какие критерии и шкалу оценки кандидатов использовать
Критерии оценки кандидатов стоит выводить из задач конкретной роли и выражать через наблюдаемые действия. Для менеджера по продажам это может быть выяснение потребности клиента. Для руководителя поддержки — разбор причины жалобы и выбор следующего шага. Общие слова вроде «профессионализм» без расшифровки мало помогают.
Для каждой компетенции команда описывает, что кандидат должен рассказать или показать. В ответе о работе с возражением важны уточняющий вопрос, понимание причины сомнения и предложенное действие. Критерий становится проверяемым, если разные интервьюеры могут найти эти признаки в одной и той же записи.
Простая шкала может включать три уровня. Первый означает, что нужного действия в ответе не видно. Второй показывает частичное проявление навыка: действие названо, но ход решения неясен. Третий предполагает конкретный пример с действиями и объяснением результата. Уровни стоит описать отдельно для каждой компетенции.
Отсутствие ответа не всегда означает отсутствие навыка. Возможно, вопрос прозвучал неясно или интервьюер не попросил пример. Поэтому полезно добавить отметку «недостаточно свидетельств», не приравнивая её автоматически к низкому баллу. Затем специалист решает, можно ли уточнить вопрос на следующем этапе.
Перед запуском шкалу проверяют на понятность: несколько интервьюеров читают её и оценивают один пробный ответ. Если слово «проактивность» каждый понимает по-своему, его заменяют описанием действия. Например, кандидат заметил риск и предложил команде следующий шаг до того, как проблема повлияла на клиента.
Как провести структурированное интервью с ИИ-оценкой
Структурированное интервью строится по общему плану: команда выбирает компетенции, готовит вопросы и согласует шкалу до встреч. Затем интервьюер проходит с кандидатами основные темы в одинаковом порядке. ИИ помогает разобрать ответы по этим правилам, а специалист проверяет результат по записи или расшифровке.
На старте руководитель вакансии и рекрутер выбирают несколько навыков, без которых трудно выполнять работу. Для каждого навыка они готовят основной вопрос и допустимые уточнения. Например, просьба описать личный вклад подходит всем кандидатам, а вопрос только об одном работодателе не должен заменять общий сценарий.
До первого интервью команда согласует, какие ответы соответствуют уровням шкалы. Полезно записать примеры сильных и неполных свидетельств, не превращая их в заученные правильные фразы. Кандидат может описать подход другими словами; оценивать нужно содержание действий, а не совпадение с образцом.
Во время беседы интервьюер задаёт общие вопросы и уточняет непонятные детали без подсказки желаемого ответа. Одинаковая структура не запрещает живой разговор. Она означает, что каждый кандидат получает сопоставимую возможность раскрыть нужные навыки, а важные уточнения фиксируются вместе с ответами.
Выбирая инструменты оценки кандидатов, команда проверяет настройку компетенций и шкалы, сохранение оснований и сопоставление результатов. Для ИИ-рекрутера OrbitAI стоит отдельно уточнить доступность этих функций и порядок проверки рекомендаций. После интервью специалист сверяет вывод с ответами и исправляет ошибки.
Оценка кандидата по впечатлению и по общей шкале
Оценка по общей шкале делает основания решения заметнее, а свободная беседа помогает исследовать неожиданные детали опыта. Эти подходы не обязаны исключать друг друга. Важные для вакансии навыки лучше проверять одинаковыми вопросами, а дополнительные темы обсуждать отдельно и не подменять ими основные критерии.
| Параметр | Оценка по впечатлению | Оценка по критериям с ИИ |
|---|---|---|
| Вопросы | Могут меняться от встречи к встрече | Основные вопросы согласованы заранее |
| Критерии | Часто остаются в голове интервьюера | Привязаны к задачам роли и уровням шкалы |
| Доказательства | Заметки могут отражать общее впечатление | Выводы связывают с конкретными ответами |
| Сопоставимость | Зависит от привычек каждого оценщика | Опирается на общие признаки, но требует проверки |
| Роль интервьюера | Самостоятельно формирует суждение | Проверяет оценку ИИ и принимает решение |
Свободная беседа может раскрыть редкий опыт, который заранее не вошёл в сценарий. Например, кандидат расскажет о выходе на новый рынок, хотя команда спрашивала о работе с текущими клиентами. Такой факт стоит записать отдельно и обсудить, но нельзя автоматически считать его заменой непроверенной обязательной компетенции.
Общая шкала уменьшает пространство для случайных трактовок, если все оценщики понимают её одинаково. Она не гарантирует полного совпадения баллов. Один интервьюер может посчитать пример достаточно конкретным, а другой заметит пропущенный результат. Именно поэтому расхождения нужно обсуждать на общих примерах.
Фиксация доказательств помогает отличить наблюдение от вывода. Фраза «кандидат уточнил бюджет и срок» описывает действие из разговора. Формулировка «умеет работать с потребностью» уже содержит оценку. Когда рядом сохранён фрагмент ответа, другой специалист может проверить, соответствует ли ему назначенный уровень.
ИИ ускоряет разбор материалов, но тоже может неверно понять контекст или пропустить уточнение. Интервьюер не должен принимать балл только потому, что система его рассчитала. Если вывод расходится с записью, специалист пересматривает оценку и фиксирует причину изменения, чтобы команда могла проверить подобные случаи.
Как калибровать скоринг и рекомендацию
Калибровка — это сверка оценок разных специалистов на одних и тех же ответах. Каждый независимо ставит баллы, затем команда разбирает расхождения и уточняет формулировки шкалы. После изменений полезно повторить проверку на других примерах, чтобы убедиться, что правила стали понятнее, а не просто подошли к одному случаю.
Для встречи по калибровке подойдут обезличенные фрагменты интервью с разными уровнями проявления навыка. Сначала участники отмечают конкретные свидетельства, затем сравнивают баллы и только после этого смотрят рекомендацию ИИ. Такой порядок помогает проверить собственные суждения, не привязываясь сразу к ответу системы.
Эти коэффициенты показывают связь оценок интервью с последующими результатами работы в рассмотренных исследованиях. Они не означают долю верных решений и не гарантируют точность для каждой вакансии. Работа также не доказывает, что конкретный ИИ-инструмент получит те же показатели: его нужно проверять отдельно.
Рекомендацию системы проверяют по ответам и правилам шкалы, а не только по итоговому баллу. Если ИИ предлагает продолжить отбор, специалист смотрит, подтверждены ли обязательные навыки. Для инструмента важна возможность увидеть основания оценки, сопоставить их с материалом интервью и зафиксировать исправление.
Как выглядит оценка кандидата на практике
Условный пример показывает, как общая шкала связывает ответ с рекомендацией. Команда ищет менеджера по продажам и проверяет выявление потребности, работу с возражением и планирование следующего шага. История ниже вымышлена: она иллюстрирует метод и не описывает результаты клиента OrbitAI.
Для первой компетенции интервьюер просит рассказать о встрече, где запрос клиента сначала был неясен. В шкале первый уровень означает отсутствие конкретных действий, второй — отдельные уточнения без объяснения, третий — вопросы о задаче, проверку понимания и связь ответа с дальнейшим предложением.
Кандидат отвечает: «Я уточнил срок запуска и спросил, почему текущий способ не устраивает команду. Потом пересказал задачу клиенту и предложил обсудить два варианта». В этом фрагменте видны уточняющие вопросы и проверка понимания. По описанной шкале система может предложить третий уровень.
Далее кандидат говорит, что клиент сомневался из-за цены, но не объясняет, как выяснил причину сомнения. За работу с возражением система предлагает второй уровень: реакция описана частично. По следующему шагу она отмечает недостаток свидетельств, поскольку кандидат не рассказал, о чём стороны договорились.
Рекомендация в таком примере — продолжить отбор и отдельно уточнить работу с возражением и завершение встречи. Интервьюер сверяет предложенные уровни с полной записью. Если нужная деталь есть в пропущенном фрагменте, он меняет оценку и сохраняет основание. Итоговое решение остаётся за специалистом.
Ограничения и контроль качества оценки
Качество ИИ-оценки зависит от критериев, вопросов и материалов интервью. Нечёткая шкала даёт системе пространство для разных трактовок, а плохая расшифровка может исказить смысл ответа. Перед разбором стоит проверить запись, обозначить пропуски и не делать уверенный вывод там, где свидетельств недостаточно.
Команда регулярно проверяет рекомендации на выборке интервью и сравнивает их с оценками специалистов. Полезно отдельно смотреть случаи с большими расхождениями и повторяющимися ошибками. Если система стабильно завышает балл за уверенную речь, критерий и инструкции к оценке нужно пересмотреть, затем снова проверить.
Общий стандарт не устраняет субъективность полностью и не защищает от ошибок в самих критериях. Требования должны относиться к работе, а не к личным особенностям кандидата. Доступ к записям ограничивают, правила обработки персональных данных согласуют с юристом, а спорные рекомендации передают человеку на проверку.
Главное о единой оценке кандидатов
Единая оценка начинается не с балла ИИ, а с понятных требований роли. Команда заранее решает, какие компетенции проверять и какие ответы подтверждают каждый уровень. Затем все интервьюеры используют общую основу и сохраняют свидетельства. Это делает обсуждение кандидатов предметнее, хотя не отменяет профессионального суждения.
Первую версию шкалы полезно испытать на небольшой выборке и обсудить случаи, где оценки разошлись. Исправления вносят до расширения процесса, а после изменений снова сравнивают результаты. Такой цикл помогает заметить неясные вопросы и проверить, действительно ли рекомендация опирается на ответы, а не на общее впечатление.
ИИ-рекомендация удобна как отправная точка для проверки, особенно при большом числе интервью. Она не должна автоматически решать судьбу кандидата. Специалист смотрит на доказательства, обязательные требования и пробелы в материалах, после чего принимает решение или назначает дополнительное интервью.
- Критерии и вопросы привязывают к задачам роли до начала интервью.
- Ответы оценивают по общей шкале и сохраняют конкретные свидетельства.
- Калибровка помогает интервьюерам согласовать трактовку уровней и разобрать расхождения.
- ИИ формирует оценку и рекомендацию, а специалист проверяет основания и принимает решение.
Хотите так же?
Оставьте контакты — перезвоним и покажем Orbit.AI на ваших задачах.