Проверка точности до покупки строится просто. Берётся 20–50 реальных звонков операторов, готовится ручная разметка, затем сравниваются выводы сервиса и эталон. Смотрятся расхождения по темам, фразам, нарушениям и эмоциям. Решение опирается на цифры по сценариям, а не на красивую презентацию и общие обещания.
Главный риск — купить «чёрный ящик». Интерфейс может впечатлить, а качество на ваших диалогах упасть. ИИ речевая аналитика точна на чистой витрине, но тонет в шумах и редких ситуациях. До оплаты нужен честный тест на своих данных и прозрачные метрики по каждому важному кейсу.
Что именно нужно проверить перед покупкой
Смысл проверки — совпадает ли оценка сервиса с живыми разговорами вашей команды. Красота интерфейса не прибавит качества к распознаванию тем, нарушений и эмоций. Нужны цифры по сценариям, где бизнес теряет деньги: срывы скрипта, отсутствие согласия, недосказанная цена, сорванные перезвоны.
На демо чаще всего всплывают типовые ошибки: переобучение на витринных звонках, игнор редких фраз, завышенные эмоции на повышенных тонах, пропуски нарушений при перебиваниях. Вдобавок сервис может путать близкие темы и списывать неточности на шум, хотя в реале это обычные условия работы.
«Речевая аналитика превращает каждый разговор с клиентом в данные: видно, где теряются сделки и что менять в скриптах.»
Тест на чужих данных не подходит. Там аккуратный звук, простые диалоги и заранее известный результат. В жизни идут параллельные разговоры, шуршание, паузы и длинные уточнения. Проверка обязана включать звонки операторов с реальным шумом, чтобы увидеть устойчивость алгоритма к повседневным помехам.
Критичны сценарии, где качество решает деньги и риски: обязательные фразы по закону, озвучивание условий, обработка возражений, фиксация следующего шага. Эти точки нужно замерять отдельно. По ним считают точность, полноту и ложные срабатывания, а не усредняют всё в один общий балл по звонку.
Как провести честное сравнение на своих звонках
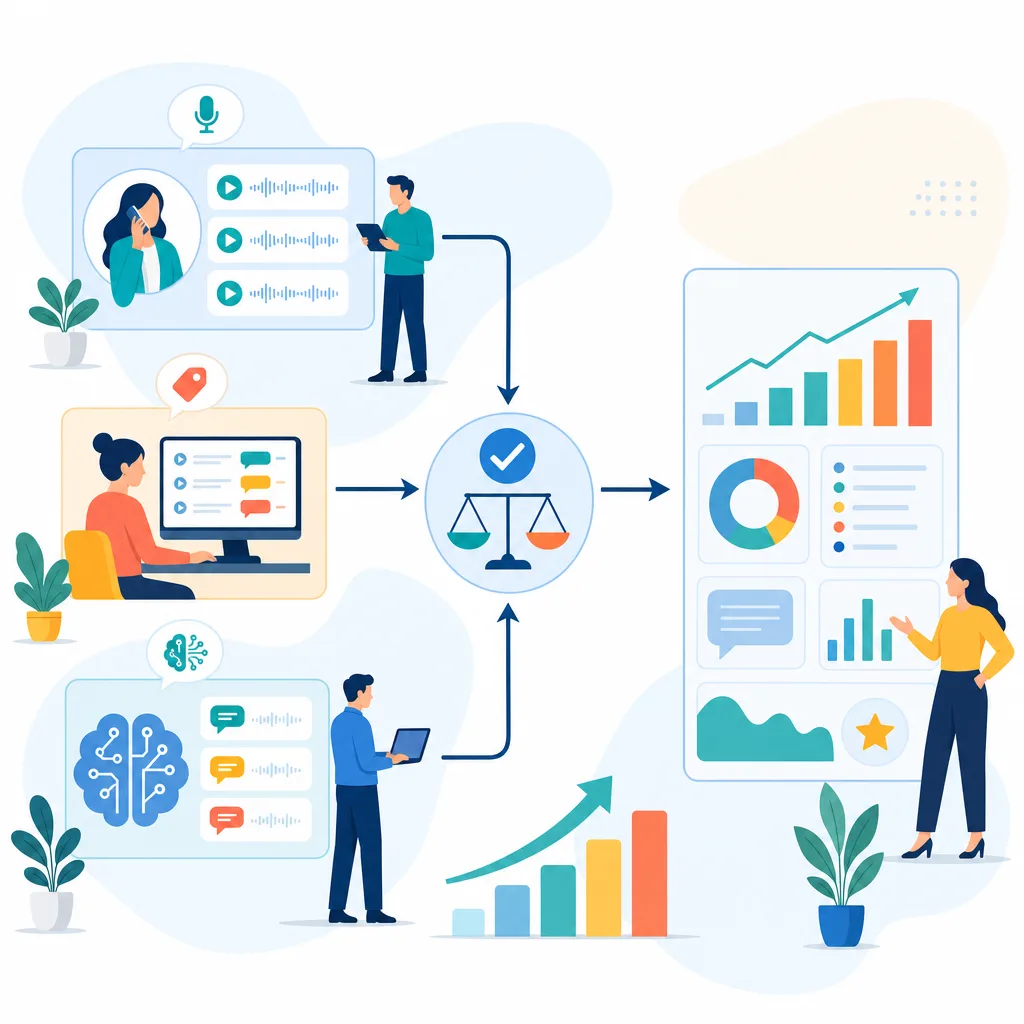
Честное сравнение строится на одинаковых правилах для машины и людей. Сначала собрать репрезентативный набор звонков операторов, потом описать чёткие критерии оценки и сделать ручной эталон. Далее прогнать те же звонки через сервис и посчитать метрики расхождений по каждому сценарию.
Пошаговая проверка точности на своих звонках
- Собрать репрезентативный пул — Выбрать 20–50 звонков из разных дней, операторов и сценариев, включить спорные и шумные кейсы.
- Согласовать критерии — Описать, что именно считается верным: тема, обязательные фразы, нарушения, эмоции, следующий шаг.
- Ручной эталон — Два разметчика помечают звонки независимо, при расхождении выносится единый эталон.
- Прогон через сервис — Загрузить те же записи, выгрузить отчёты по тем же критериям без ретуши и постфакта правок.
- Сравнение и метрики — Свести совпадения, ложные срабатывания и пропуски по каждому сценарию, сделать сводку.
Подготовку удобно оформить как короткий чек-лист. Тогда команда быстро отметит, что собрано, а что ещё нужно. Все критерии и названия сценариев стоит зафиксировать в одном файле. Это исключит споры о трактовках и уберёт риск подгонки результата под желаемую картинку.
Подготовить набор звонков
Нужны 20–50 реальных звонков операторов из разных потоков: продажи, поддержка, взыскание. Включить опытных и новичков, будние и пиковые часы. Обязательно добавить шумные записи, перебивания, параллельные обсуждения. Без спорных кейсов тест даст ложную уверенность и не покажет реальные провалы.
Разбейте выборку на сценарии: приветствие, сбор потребности, презентация, цена, согласие, следующий шаг. По каждому сценарию отметьте обязательные фразы. Иначе итог упрётся в общий балл по звонку и спрячем критичные ошибки в среднем. Баланс по полу и регионам тоже помогает раскрыть срывы.
Задать одинаковые критерии оценки
Опишите, что считать правильным: тема разговора, точные формулировки ключевых фраз, признаки нарушения, эмоциональная окраска и факт фиксирования следующего шага. Для спорных моментов заранее дайте пример. Это снимет двоякие трактовки и совпадёт с тем, что потом посчитает сервис.
Где сложно автоматизировать смысл, делайте ручной эталон. Например, суть возражения, ирония, сарказм. Для эмоций договоритесь о шкале. Пусть два разметчика метят независимо. При расхождении фиксируйте консенсус и короткий комментарий. Такой эталон пригодится для повторных сравнений.
Сравнить результат сервиса с ручной разметкой
Выгрузите из сервиса отчёт по тем же критериям. Проверьте совпадения и расхождения на уровне сценариев, а не только по звонку целиком. Посчитайте точность, полноту, долю ложных срабатываний и пропусков. Отдельно отметьте стабильность по шумным и длинным диалогам, где ложные флаги чаще.
Отмечайте примеры. Где сервис поймал тему, но пропустил обязательную фразу. Где нашёл нарушение не там. Карман с примерами даст ясность руководителю и покажет, можно ли контролировать все звонки без просадки по качеству. Кейсы станут основой для договорённостей о дообучении и SLA.
Что важнее: точность, охват или удобство
Приоритет — точность на критичных сценариях. Охват нужен, но массовая обработка бессмысленна, если путаются темы и теряются обязательные фразы. Скорость важна там, где требуются быстрые перезвоны. Удобство отчётов упрощает работу, но не заменяет надёжную классификацию и чёткие метрики.
Если цель — контроль рисков, сначала замеряйте точность и полноту по юридическим и комплаенс-фразам. Для роста конверсии смотрите корректность презентации и цены. Охват подключайте, когда качество стабилизировалось на нужном уровне. Иначе отчёт станет списком ложных тревог и пустых задач.
Удобство стоит сравнивать только после качества. Плитки и фильтры не исправят путаницу в темах. Хороший сервис даёт точные теги и прозрачные примеры, а уже потом быструю навигацию. Тогда руководитель видит, где упал сценарий, и как быстро вернуть контроль, не теряя темпа в операциях.
Сравнение подходов: демо на чужих данных vs проверка на своих звонках
Демо даёт впечатление, тест на своих звонках даёт правду. На витрине мало шума и неожиданных поворотов. На реальных записях видно, где модель путается и как держит качество в потоке. Сравнение по таблице ниже помогает быстро объяснить разницу команде и принять взвешенное решение.
| Критерий | Демо на чужих данных | Проверка на своих звонках |
|---|---|---|
| Качество оценки | Высокое на простых кейсах | Измеряется по вашим сценариям и шумам |
| Видимость ошибок | Скрыта подбором «красивых» примеров | Ошибки видны в примерах и метриках |
| Релевантность сценариев | Не совпадает с вашим процессом | Совпадает с реальной воронкой |
| Скорость результата | Мгновенно, но не про ваш поток | 1–3 дня на разметку и сводку |
| Риск ошибочной покупки | Высок | Низкий при честном сравнении |
Таблица подчёркивает главный вывод: реальный тест раскрывает качество там, где бизнесу больно. Видно, выдержит ли сервис пики нагрузки и редкие формулировки клиентов. Демо не покажет поведение на диалогах с перебиваниями, ироничными репликами и длинными паузами на уточнения.
Когда демо вводит в заблуждение
Демо часто готовят на «правильных» записях: чистый звук, короткие фразы, предсказуемый сюжет. Редкие слова и региональные акценты вырезаны. В таких условиях любая модель выглядит прилично. Но как только пошёл реальный поток, метрики проседают, а отчёты заполняются ложными тревогами.
Ещё одна ловушка — заранее ожидаемый результат. Поставщик выбирает звонки, где совпадения гарантированы. Команда теряет время на обсуждение презентации, а не качества. Правильный ход — просить прогон своих записей без предобработки и смотреть сырые примеры рядом с ручной разметкой.
Что даёт тест на своих данных
Виден реальный шум: фоновая музыка, курьеры в офисе, параллельные обсуждения. Видно, как сервис ведёт себя на длинных уточнениях и обрывах связи. Ошибки классификации быстро всплывают в сводке, а примеры помогают договориться о дообучении. Так принимается решение по делу, а не по витрине.
К тому же тест показывает применимость под ваш процесс. Понятно, как отчёты ложатся на контроль качества, какие фильтры нужны руководителю, и где добавить теги. Если результат стабилен, становится реалистично контролировать все звонки и сократить ручные проверки без потери смысла.
Какие метрики запросить у поставщика
Запросите точность и полноту по каждому сценарию отдельно. Попросите долю ложных срабатываний и долю пропусков. Добавьте время обработки на 1 час аудио и устойчивость к шуму. Сверьте всё с ручным эталоном. Цифры должны выходить из ваших звонков, а не из обобщённой рекламной выборки.
По ключевым фразам фиксируйте не только факт, но и контекст. Например, «цена от…» без условий — это промах. По нарушениям важна строгая логика: есть флаг — есть пример в записи. По эмоциям просите калибровку на ваших репликах. Иначе модель будет метить раздражение там, где обычная речь.
Эти цифры мало что дают без разреза по сценарию. Там, где точность ниже порога, нужна донастройка или отказ от автоматической метки. Там, где полнота просела, будет недосчёт реальных нарушений. Финальная сводка по сценариям яснее любого среднего балла по звонку.
Обязательно соберите примеры пограничных ситуаций. Пусть поставщик объяснит логику и предложит план улучшений. Договоритесь о контрольном повторе через неделю на тех же звонках операторов. Если метрики растут и стабилизируются, проект двигается. Если плавают — риск высокой цены владения.
Как понять, что сервис можно внедрять
Признаки «да»: точность и полнота на ключевых сценариях выше порога, ошибки предсказуемы и снижаются на повторном тесте, отчёты читаемы без долгих инструкций. Важно, чтобы спорные примеры объяснялись и закрывались планом дообучения с понятным сроком и ответственным.
Допустимые расхождения зависят от цены ошибки. Юридические фразы — почти безошибочно. Презентация — чуть свободнее, но с контролем ключевых слов. Эмоции — аккуратно и с оглядкой на контекст. Если качество ниже порога в важном сценарии, откладывайте покупку до исправления.
Решение ускоряет короткий SLA: метрики, сроки улучшений, ответственные и формат контрольного прогона. Запишите, как часто обновлять модель и на каких данных. Так проверка превращается в процесс, а не в разовое шоу. Потом этот цикл поддержит стабильность и в масштабной эксплуатации.
Когда есть стабильное качество, становится реальным план контролировать все звонки. Команда снимает рутину с выборочных прослушек и переключается на коучинг. ИИ речевая аналитика берёт на себя первичный разбор, а эксперты точечно работают с провалами, которые видны в отчётах и примерах.
Итог прост: покупка оправдана, когда цифры на ваших записях подтверждают ценность, а поставщик прозрачено ведёт улучшения. Тогда инструмент помогает, а не требует бесконечных настроек и ручных костылей. И бюджет тратится на рост качества, а не на борьбу с ложными тревогами.
- Проверяйте на своих звонках операторов с ручным эталоном и едиными критериями.
- Считайте точность, полноту, ложные срабатывания и пропуски по сценариям.
- Демо на чужих данных даёт иллюзию качества, а не правду о вашем потоке.
- Решение о покупке — по метрикам и примерам, а не по интерфейсу.
- Повторный прогон подтверждает стабильность и готовность к масштабированию.
Хотите так же?
Оставьте контакты — перезвоним и покажем речевую аналитику на ваших звонках.