Что считать эффективностью ИИ-тренажёра
Эффективность — это измеримый рост в речевых навыках и результатах звонков. Счёт идёт по качеству диалога, снижению ошибок, скорости освоения сценариев, стабильности между сессиями и переносу навыка в поле. Важна не разовая победа, а устойчивая динамика. Эмоциональные оценки не заменяют цифры и контрольные сравнения.
Рост качества диалога отражают чек‑листы: структура, прояснение потребности, работа с тишиной, итоговое согласование. ИИ тренажёр отрабатывает реалистичные диалоги, где оператор встречает типовые и редкие ветки. Балл должен расти не только по сумме пунктов, но и по критическим элементам: квалификация, следующий шаг, фиксация договорённости.
Снижение ошибок видно по частоте критических промахов: неверные обещания, некорректная информация, пропуск обязательной реплики. Отдельно отмечают ошибки, что ведут к эскалациям и штрафам. В AI тренажёр закладывают детекторы таких событий и метят их в отчёте. Цель — не ноль, а устойчивое падение и отсутствие возврата к старому паттерну.
Скорость освоения сценария — сколько сессий нужно, чтобы выйти на целевой балл в симуляции. Быстрый прогресс важен для онбординга и вывода на линию. Но скорость без удержания мало что говорит. Поэтому рядом ставят показатель повторной проверки через несколько дней: оператор сохраняет уровень или теряет баллы.
Стабильность результата — разброс оценок по дням и сессиям. Хороший прогресс выглядит как сужение диапазона: меньше провалов, больше попыток в коридоре цели. Отдельно проверяют новые ветки: не только знакомая история, но и редкие возражения. Чем ниже разброс при росте среднего балла, тем надёжнее навык.
«Речевая аналитика превращает каждый разговор с клиентом в данные: видно, где теряются сделки и что менять в скриптах.»
Перенос в реальные звонки — главный критерий. Если симуляция растёт, а на линии нет изменений, тренажёр не решает задачу. Переносят через одинаковые метрики: точность реплик, время на звонок, конверсия в следующий шаг, ошибки. Смотрят до/после и удержание через 2–4 недели, чтобы отфильтровать эффект новизны.
Статистика не заменяет локальные измерения. Она показывает направление и потолок, а проверка делается на своих сценариях. Для оценки пользы ИИ тренажёр должен давать управляемую практику, а дашборд — сравнимые ряды по людям, сменам и темам диалога. Тогда решение опирается на факты, а не на впечатление.
Какие метрики сравнивать в симуляциях и в реальных звонках
Сравнение строится на одинаковых определениях. Из симуляций берут баллы чек‑листа, ошибки, скорость освоения и стабильность. Из звонков — QA‑оценку, конверсию в действие, время разговора, эскалации и возвраты. Сначала приводят метрики к одной шкале и одинаковому периоду, затем считают разницу до/после и тренд.
Из тренажёра удобно брать разрезы по веткам: приветствие, выяснение, презентация, работа с возражениями, закрытие. Реалистичные диалоги помогают точнее понять узкие места. В звонках те же этапы размечаются по записям или автотранскрибуции. Когда этапы совпадают, сравнение перестаёт «прыгать» из‑за разных определений.
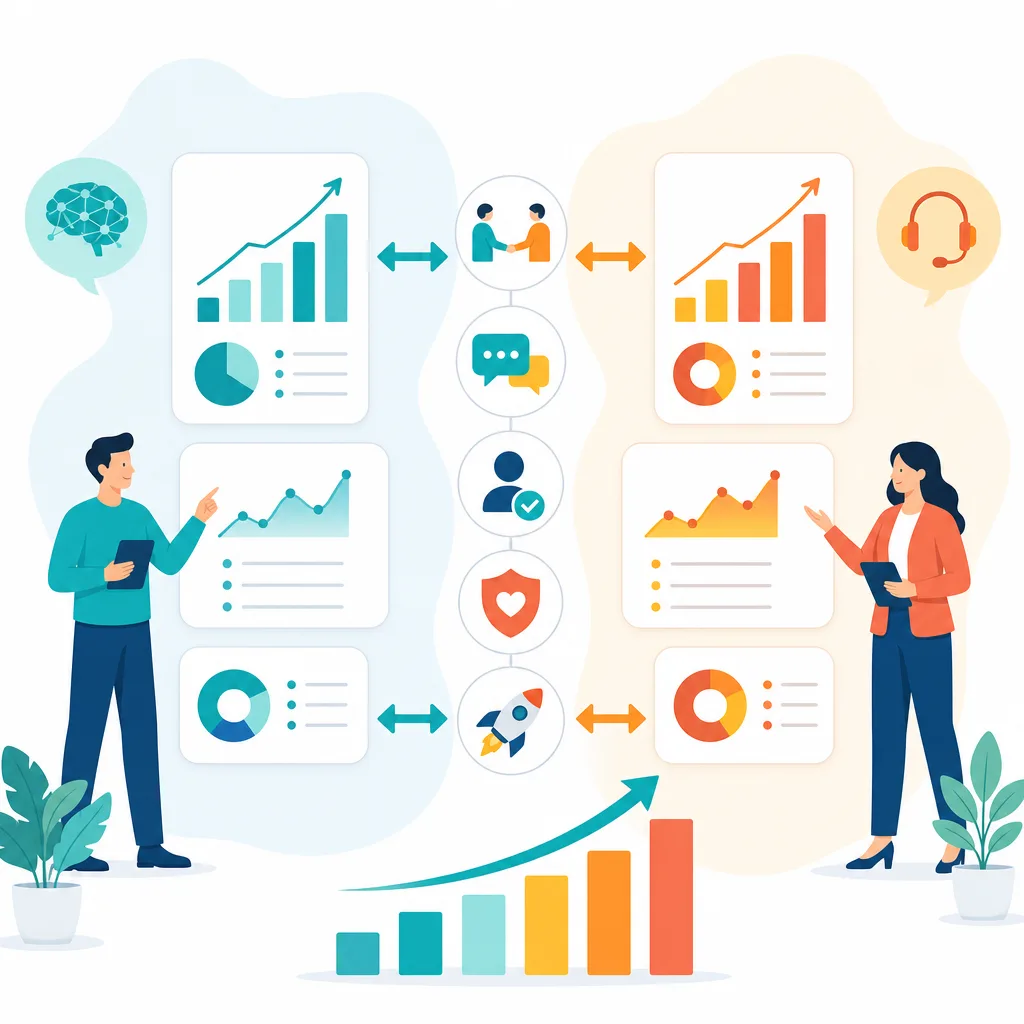
Из звонков добавляют исход бизнеса: договорённость о встрече, счёт, апселл. Это закрывает разрыв между навыком и результатом. Если навык растёт, а исход не меняется, причина может быть в трафике или оффере. Чтобы не спутать факторы, фиксируют изменения условий: акции, цены, сезон и перераспределение лидов.
| Метрика | В симуляции | В реальных звонках | Что показывает |
|---|---|---|---|
| Точность сценария | Доля верных реплик и ответов на контрольные вопросы | Доля корректных ответов на возражения и соблюдение скрипта | Освоение канвы и логики беседы |
| Качество диалога | Балл чек‑листа: структура, темп, прояснение, закрытие | Оценка QA и сигналы по записям: структура, ясность, итог | Управляемость разговора и восприятие клиентом |
| Ошибки | Частота критических промахов по детекторам | Эскалации, неверные обещания, нарушения политики | Риски и стоимость исправления |
| Скорость освоения | Сессии до целевого балла по веткам | Недели до выхода на целевую конверсию | Темп онбординга и время до результата |
| Стабильность | Разброс баллов между попытками и днями | Вариативность метрик по дням и сменам | Надёжность навыка под нагрузкой |
| Перенос навыка | Прогресс по редким веткам и возражениям | Изменение конверсии и ошибок в схожих кейсах | Реальное влияние практики на поле |
| Паузы и темп | Средняя/максимальная пауза, перебивания | Паузы по записям, доля перекрытий | Комфорт и управляемость ритма |
| Адаптация | Доля корректных отступов от скрипта | Соотношение соблюдения и импровизации vs исход | Зрелость гибкости без потери цели |
Не смешивай несопоставимое: разный трафик, сезон, новые офферы, смена тарифа. Нормализуй по источнику лидов, типу клиента и сложности кейсов. Сравнивай одинаковые отрезки: 2 недели до и 2 недели после. Если мощности мало, используй скользящее среднее и бутстрап, чтобы не ловить шум в одном дне.
Для сложных сценариев заводят уровни: базовые, средние, продвинутые. Прогресс считают по каждому уровню отдельно и по сводному баллу с весами. Тогда перемещение операторов между очередями не ломает сравнение. В отчёте явно укажи весовую модель: где важнее безопасность, где сильнее ценят скорость.
Как понять, что ИИ-тренажёр работает лучше обычной практики
Сравнивай две дорожки: тренажёр и обычные разборы. При равных условиях выигрывает та, что быстрее даёт стабильный навык и перенос в звонках. ИИ тренажёр эффективнее менеджеров, когда узкие места быстро закрываются повторяемой практикой, а качество растёт не разово, а удерживается на линии без подгона.
Обычная практика держится на теневом прослушивании и редких сессиях с наставником. Она полезна, но тяжело масштабируется. ИИ тренажёр закрывает объём: даёт десятки попыток в день, реалистичные диалоги по редким возражениям и быстрый фидбэк. Менеджер сохраняет роль эксперта и куратора, а рутина уходит в симуляции.
Корректный вывод строится на A/B‑разделении или поочерёдном запуске. Группы получают одинаковый трафик и цели. Если «симуляция» показывает рост в чек‑листе, а звонки дают плюс к конверсии и минус к ошибкам быстрее, чем в контроле, тренажёр выигрывает. Иначе победа — эффект состава или сезона.
Когда ИИ тренажёр эффективнее менеджеров? В повторяемых навыках: структура, отработка возражений, чёткое закрытие. Машина тут даёт больше повторов и равномерный фидбэк. Когда нет? В уникальных переговорах с высокой ценой сделки и множеством внешних факторов. Там решают совместные разборы и сценарное планирование.
Смотри на стоимость улучшения. Считай человеко‑часы менеджеров, время операторов вне линии, отток лидов из‑за обучения. Если симуляция даёт тот же или больший прирост качественных метрик за меньшую стоимость и с лучшим удержанием, вывод очевиден. Если экономии нет, тренажёр требует перенастройки целей.
Полезно сравнивать не среднее, а распределения. Тренажёр часто «поднимает хвосты» — слабые перестают проваливаться. Это снижает риск клиентских инцидентов. Если среднее примерно равно, но хвост сжат, это плюс. В отчёте покажи процент операторов, вышедших на целевой уровень, и скорость, с которой они туда дошли.
Как проверять перенос навыка из симуляции в звонки
Перенос проверяется треком до/после/на линии. Сначала базовая неделя без тренажёра, затем неделя практики, потом 2–4 недели на звонках. Метрики одинаковые и нормализованные по сложности. Валидный перенос — когда рост виден в полевых показателях и удерживается без подсказок, а откат ниже шума.
До тренажёра зафиксируй базу: чек‑лист, частоту ошибок, среднюю паузу, конверсию в следующий шаг, эскалации. Разбей по сценариям и веткам. Если уже шёл коучинг, отметь это в карточке эксперимента. База не должна включать промо‑акции и аномальные дни, иначе перенос перепутается с сезонностью.
После недели в симуляции проверь те же показатели в контрольной сессии. Важно вернуть сложные ветки, а не только базу. Оцени удержание через 3–5 дней без повторов. Если балл держится, переходи к звонкам. Если падает, настраивай ИИ тренажёр: больше редких веток, чаще обратная связь, точнее детекторы ошибок.
На реальных звонках отслеживай метрики ежедневно, но вывод делай по неделе и двум. Применяй окно равной длины для контроля. Сохраняй разрез по источникам лидов и операторским сменам. Добавь качественную верификацию: прослушай 10–15 случаев на каждую проблемную ветку и отметь совпадение ошибок с симуляцией.
Динамику удобно показывать когортою: набор операторов, стартовавших в одну дату. По ней строится график конверсии, ошибок и длительности звонка. Если перенос есть, кривые когорты уходят выше контроля и не сдуваются через 2 недели. При расхождении вернись к тегированию сложных кейсов и корректировке весов.
Атрибуция эффекта — отдельная проверка. Зафиксируй, что ещё менялось: скрипт, оффер, цены, промо. Если изменений много, используй поочерёдный запуск по очередям или кластерам лидов. Это даст шанс отделить вклад тренажёра от внешних факторов и аккуратно оценить прирост в каждой метрике.
Какие ошибки ломают оценку эффективности
Оценку чаще всего портят четыре вещи: сравнение несхожих групп, короткое наблюдение, опора на субъективные отзывы и игнор сложности сценариев. Лечатся они выравниванием условий, достаточной длиной окна, чёткими метриками и тегированием веток. Тогда картинка перестаёт искажаться и спор сводится к цифрам.
Сравнение разных групп без выравнивания даёт ложный вывод. Если в тренажёре учились новички, а контроль — опытные, общий рост скажет мало. Выравнивай по стажу, типу кейсов и источникам трафика. Когда это невозможно, используй разницу разниц: группа минус контроль до/после, а не грубые средние.
Короткий период наблюдения ловит шум. Один удачный день делает иллюзию прогресса, а следующий её рушит. Минимум — неделя до и неделя после, лучше две. Для редких сценариев окно растягивают, пока не наберут статистически устойчивый объём. Скользящее среднее и медиана помогают приглушить всплески.
Оценка только по субъективному впечатлению смещает вывод. Позитивные отзывы важны, но они не заменяют QA‑баллы, ошибки и конверсию. В отчёте оставь отзывы как иллюстрации, а не доказательство. Особенно осторожно с эффектом новизны: первые дни все бодры, через неделю режим становится рутиной.
Игнор сложности сценариев ведёт к некорректным сравнениям. Возражение «дорого» и редкий комплаенс‑кейс не равны по весу. Тегируй ветки и присваивай веса. Тогда плюс в простой теме не перекроет провалы в критичных. Для честности публикуй шкалу весов и примеры отнесения кейсов к уровням.
Ещё два перекоса — подбор удобной выборки и смена метрики под результат. Лечи это заранее: заморозь список метрик и формулу сводного балла, опиши критерии исключения аномалий. Пусть к ним относится одинаковое правило для контроля и теста. Прозрачный протокол предотвращает спор задним числом.
Как оформить понятный отчёт по эффективности
Отчёт должен отвечать на три вопроса: что было, что сделали, что изменилось. В него входят цели, группа, период, метрики и метод сравнения. Ключ — наглядная динамика и перенос в звонки. Сначала вывод в одном абзаце, затем цифры и примеры. Без рекламных эпитетов и без скрытых допущений.
Цифры: базовый уровень, после симуляций и на звонках. Для каждой метрики — среднее, разброс и доля операторов, вышедших на цель. Для звонков — конверсия в следующий шаг, ошибки, эскалации, средняя длительность. Отдельно — удержание через 2–4 недели. Всё в разрезе сценариев и источников трафика.
Таблицы: сопоставление метрик, описание групп, веса сценариев. Графики: когорты и распределения, а не только среднее. Примеры: два‑три разметенных звонка на сложных ветках с цитатами. Это связывает цифры и живую речь. Для AI тренажёр приложи карту веток и примеры фидбэка с пометкой ошибок.
Выводы: коротко, без воды и мягких слов. «Было/стало», «перенос подтверждён/не подтверждён», «стоимость улучшения». Если ИИ тренажёр дал рост в чек‑листе и в звонках при равных условиях, так и напиши. Если эффект неустойчив или виден только в симуляции, предложи план донастройки и вторую проверку.
Мини‑шаблон: цель и гипотеза, дизайн сравнения, описание трафика, метрики и веса, результаты по симуляциям, результаты по звонкам, удержание, стоимость, риски и ограничения, вывод и план. Приложения — протокол тегирования, чек‑листы, карта веток и ссылки на записи. Формула сводного балла — отдельным блоком.
Короткое резюме для руководителя уходит на первую страницу. Три цифры: прирост по ключевой метрике, доля операторов, вышедших на цель, и оценка стоимости улучшения. Одна таблица и один график. Ссылки на детали — ниже. Такой формат экономит время и не теряет фактуру для глубокой проверки.
Итог: когда результат можно считать доказанным
Результат засчитывается, когда рост есть в симуляции и на звонках, удерживается 2–4 недели и устойчив к смене трафика. Группы выровнены, окно одинаковое, веса сценариев известны. Стоимость улучшения не растёт быстрее эффекта. Всё это подтверждено таблицами, графиками и примерами речевых случаев.
Если рост виден только в симуляциях, это учебный эффект без переноса. Если только в звонках — вероятно, повезло с трафиком. При разнобое не спеши с итогом: вернись к тегам, уравняй периоды, проверь состав групп. Повтори запуск на новой когорте. Доказанным считается результат, который повторяется.
ИИ тренажёр — инструмент для системной практики, а не магия. Его сила в объёме повторов, точном фидбэке и контролируемой сложности. Когда это соединяется с честным сравнением и понятными метриками, решение по эффекту не спорное. Оно опирается на факты и не рассыпается при повторной проверке.
- Счёт по набору метрик: качество, ошибки, скорость, стабильность, перенос
- Сопоставляй одинаковые окна, сложность и источники трафика
- Главный критерий — перенос в реальные звонки и удержание эффекта
- ИИ тренажёр выигрывает в повторяемых навыках и объёме практики
- Отчёт: короткий вывод, затем цифры, разрезы и примеры кейсов
Хотите так же?
Оставьте контакты — покажем тренажёр на ваших сценариях и метриках онбординга.